Mistral'ın Timestral Modeli 0.003 MASE Farkla 1. Oldu. Test Ettim — Asıl Değişken Model Değildi.
Kaynak: dev.to
İçindekiler 2 başlık
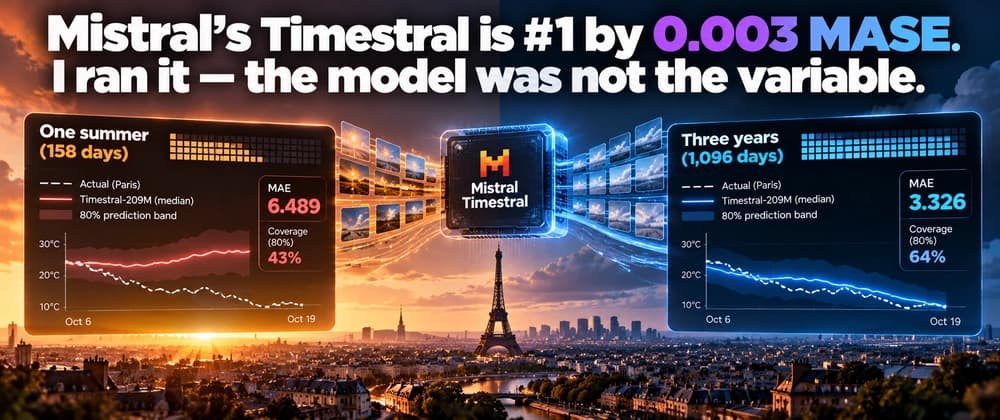
Aynı model, aynı 14 günlük Paris hava durumu verisi ve aynı test kümesi (holdout). Aşağıdaki karşılaştırmada değiştirdiğim tek şey, modele sunduğum geçmiş veri (context) miktarıydı:
- Timestral-209M, bağlam = bir yaz (158 gün): MAE 6.489 (%80 bandı gerçeği %43 oranında kapsadı)
- Timestral-209M, bağlam = üç yıl (1.096 gün): MAE 3.326 (%80 bandı gerçeği %64 oranında kapsadı)
- "Dünü tekrarla" (model yok): MAE 5.636
Pencerede yalnızca tek bir yaz verisi varken, Mistral'ın yeni son teknoloji tahminleme modeli, sadece son değeri tekrar eden basit bir referans (baseline) yöntemine yenildi. Ancak pencereye üç Ekim ayı dahil edildiğinde, tüm referans yöntemleri üçte bir oranında geride bıraktı. Üstelik ailenin en küçük modeli (diskte 20.8 MB), 837 MB'lık amiral gemisi modelin sadece 0.03 puan gerisine yerleşti.
Burada farkı yaratan değişken parametre sayısı değil, bağlamdı (context). Hiçbir liderlik tablosu size bunu söylemez; ancak 90 satırlık bir test betiği bunu açıkça ortaya koyar.
Lansman ve "Birinciliğin" Arkasındaki Rakamlar#
15 Ekim'de Mistral, ilk zaman serisi temel model ailesi olan Timestral'ı yayınladı:
- 5M, 28M, 123M ve 209M parametreli dört açık ağırlıklı (open-weight) kontrol noktası
- 21 kantil (quantile) ile sıfır atışlı (zero-shot) tahminleme ve 32.768 adıma kadar bağlam desteği
- CPU veya GPU üzerinde PyTorch uyumluluğu ve Apache-2.0 lisansı altında GitHub kodu
Duyuru oldukça netti: Model, alanın üç ana açık kıyaslama testinde (GIFT-Eval, TIME ve fev-bench) birinci sırada yer alıyor ve önceden eğitilmiş sıfır atışlı modeller arasında beş metriğin tamamında liderliği göğüslüyordu. Ancak model kartındaki tabloda yer alan birinci ve ikinci sıradaki (t0-gamma) sonuçları karşılaştırdığımızda farkların ne kadar küçük olduğu görülüyor:
- GIFT-Eval MASE ↓: 0.658 vs 0.661 (Fark: 0.003)
- GIFT-Eval CRPS ↓: 0.446 vs 0.452 (Fark: 0.006)
- TIME MASE ↓: 0.626 vs 0.637 (Fark: 0.011)
- TIME CRPS ↓: 0.522 vs 0.534 (Fark: 0.012)
- fev-bench SQL skill ↑: 50.39 vs 49.42 (Fark: 0.97)
- fev-bench MASE skill ↑: 39.49 vs 37.99 (Fark: 1.50)
Ana kıyaslama testindeki birincilik, binde üçlük bir MASE puanına dayanıyor. Hacker News yorumcularının da belirttiği gibi, grafiklerde devasa görünen farklar aslında tablolarda çok küçük marjlara tekabül ediyor ve blog yazısında gerçek bir müşteri referansı yerine kurgusal bir senaryo ("Binlerce sensöre sahip bir endüstriyel tesisi düşünün") yer alıyor. Bunların hiçbiri modeli kötü yapmaz; ancak geliştiriciler için süslü grafiklerden önce ham tabloları okumanın önemini hatırlatır.
Duyurudaki bir cümle ise yapılacak testin yönünü belirledi: "Eğitim verilerinin çoğunluğu sentetikti." Modeller önce üretilmiş süreçler (trendler, mevsimsellik, gürültü) üzerinde önceden eğitilmiş, ardından gerçek ve sentetik veri karışımıyla son eğitime tabi tutulmuştu. Yani sentetik seriler bu modellerin kendi eviydi.
Topluluğun İstediği Test ve Geliştiriciler İçin Çıkarımlar#
Tartışmaların arasında deneyimli bir uzmanın önerdiği test protokolü dikkat çekiciydi: Bir tahmin modelini anlamlı şekilde test etmek için, klasik bir yöntemin sinyalin çoğunu yakalayabildiği yüksek sinyal-gürültü oranına sahip bir veri üretme süreci kullanılmalı (Test A) ve ardından modelin gerçek dünyadaki gürültülü verilerdeki (Test B) performansı ölçülmelidir.
Yazılım Geliştirme ve Mühendislik Çıkarımları:
- Model Boyutu Yerine Bağlamı Optimize Edin: 20.8 MB'lık en küçük modelin 837 MB'lık modelle neredeyse aynı sonucu vermesi, üretim ortamında (production) maliyet ve bellek optimizasyonu için devasa modeller yerine doğru bağlam penceresiyle beslenen küçük modellerin (
Modeller: Hangisi, Ne Zaman?) çok daha verimli olabileceğini gösterir. - Basit Baseline Testlerini Atlamayın: Doğru veri geçmişi sağlanmadığında en gelişmiş model bile "dünü tekrarla" mantığına yenilebilir. AI test stratejilerinizde (
AI Test Stratejileri) her zaman basit istatistiksel referans noktaları bulundurun. - Sentetik Veri Sınırlarını Bilin: Sentetik verilerle eğitilen modeller teorik kalıplarda harika çalışsa da, gerçek dünya verilerinde mevsimselliği yakalamak için modele yeterli geçmişi sunmanız şarttır.
Kaynak ve atıf
Bu yazı, dev.to üzerinde yayımlanan içerikten yararlanılarak Edumints tarafından yapay zekâ desteğiyle Türkçe hazırlandı. Ayrıntılar ve yazarların kendi anlatımı için orijinaline bakabilirsin:
- dev.to/slabb/mistrals-timestral-is-1-by-0003-mase-i-ran-it-the-model-was-not-the-variable-1bf8