LLM Hakeminiz Size Biraz Yalan Söylüyor
Kaynak: dev.to
İçindekiler 4 başlık
Kapsam notu: Bu çalışma İngilizce ağırlıklı 7 etiketleme görevini, 3 orta seviye hakemi (2 yerel, 1 API), her biri için tek çalıştırmayı ve 0,29 dolarlık API harcamasını kapsar. Aşağıdaki veriler, önceden kayıtlı çalışmaya (846 yapılandırma × 2.000 tekrar) dayanmaktadır.
LLM hakeminiz (LLM-as-a-Judge) sisteminizin %72 başarı elde ettiğini söylüyor. Ancak gerçek değer —tüm veriler insanlar tarafından etiketlendiğinde çıkacak sonuç— %65’tir. Hesapladığınız ±%1’lik güven aralığı ise gerçeği değil, yalnızca modelin kendi görüşlerini yansıtır. Yapılan ölçümlerde, yalnızca LLM hakemine dayanan aralıklar 7 gerçek görevdeki 21 görev-panel kombinasyonunun 18'inde gerçek insan değerini ıskalamıştır.
Yazılım ekiplerinin sıkça başvurduğu "kontrol için rastgele 100 örneği elle etiketleyelim" çözümü geçici ve yetersizdir. Kimse 100 örneğin yetip yetmeyeceğini, hangilerinin seçileceğini veya bunların 5.000 model etiketiyle nasıl birleştirileceğini bilmez. FewHumans kütüphanesi bu üç soruyu geçerli istatistiklerle yanıtlar: insanların hangi verileri etiketleyeceğini yönlendirir, iki kaynağı tahmin destekli çıkarım (PPI) ile birleştirir ve her an geçerli (anytime-valid) aralıklarla ne zaman durmanız gerektiğini söyler.
Kurulum (Setup)#
Üç hakem model (Ollama üzerinden yerel Qwen 9B ve 4B ile toplam 0,29 dolar maliyetli gpt-4o-mini), 7 görevi etiketledi: HelpSteer2 ve SummEval derecelendirmeleri, MT-Bench ve Arena tercihleri, WMT çeviri puanları, toksisite bildirimleri ve OracleBench matematik kararları. İstemler (prompts) simülasyon öncesi donduruldu. Gerçek değer (ground truth) insan etiketleridir ve stratejiler bir etiketi yalnızca "satın aldıklarında" görebilirler.
Sonuçlar (Results)#
Önceden kayıtlı, 846 yapılandırma × her biri 2.000 tekrar:
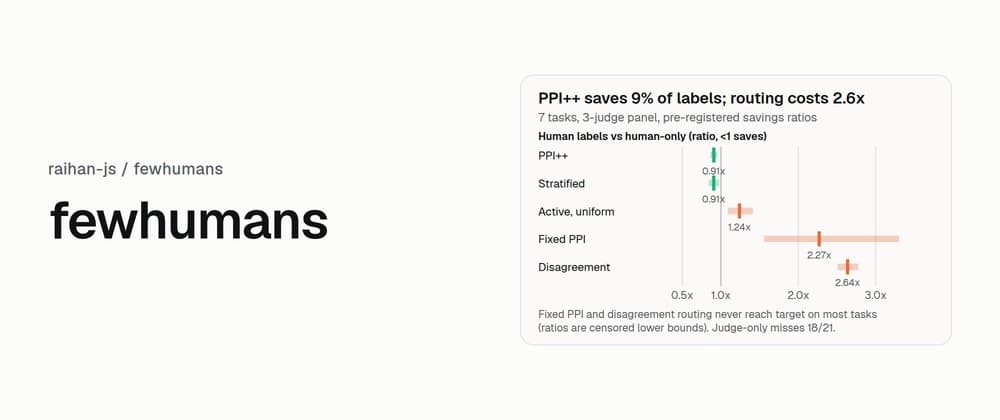
- PPI++: 0.91 [0.87, 0.95] — İnsan etiketlerinde ~%9 tasarruf sağlar. Mütevazı ama gerçek bir kazanım.
- Katmanlı (Stratified) PPI++: 0.91 [0.84, 0.98] — Daha basit varsayımlarla aynı tasarruf oranı.
- Sabit (Fixed) PPI: 2.27× — Etiket maliyetini artırır. Orta seviye hakemlerle (%45–77 uyum) ayarlanmamış $\lambda=1$ kullanımı gürültü ekler. Güç ayarı (power tuning) olmadan asla PPI çalıştırmayın.
- Uyuşmazlık Yönlendirmesi (Disagreement routing): 2.64× — Uyuşmazlık durumu hataları tahmin etse bile (0.80'e kadar AUROC), 7 görevin 6'sında etiket maliyetini artırır. Ters olasılık ağırlıkları (inverse-probability weights), sinyalin sağladığı faydadan çok daha hızlı bir şekilde varyansı patlatır. Sezgisel olarak "modelin emin olmadığı yerlere insan baksın" demek mantıklı görünse de istatistiksel pratikte bu bir tuzaktır.
- Yalnızca Hakem (Judge-only): 21'de 18 ıskalama — Sözel güven skorları her yerde aşırı iyimserdir (0.98'e varan kalibrasyon hatası).
Her varsayılan aralık önce 196 yapılandırmalı bir kapsama kapısından (coverage gate) geçmiştir (Student-t aralıkları; katmanlı yapı $n \ge 100$, çarpık gerçeklik ise $n \ge 200$ gerektirir).
Sınırlamalar (Limitations)#
- Tasarruf oranı 10 kat değil, ~%9 civarındadır; "çöp girerse çöp çıkar" (garbage in, garbage out) kuralı burada da geçerlidir.
- Çalışma İngilizce ağırlıklı 7 görev, 3 orta seviye hakem ve tek çalıştırma ile sınırlıdır.
- Oran tahminleyicileri (F1 skoru gibi) henüz dahil edilmemiştir.
- Aktif yönlendirme, bazı iş akışlarında bulunmayan kaydedilmiş olasılıklara (logged probabilities) ihtiyaç duyar.
- Yüksek riskli alanlarda bu yöntem insan incelemesini azaltır ancak asla tamamen ortadan kaldırmaz.
Yeniden Üretilebilirlik ve Pratik Çıkarımlar (Reproduce)#
Sisteminizi test etmek ve kendi değerlendirme boru hattınıza (evaluation pipeline) entegre etmek için kütüphaneyi doğrudan deneyebilirsiniz:
pip install fewhumans
pytest # 47 test
python examples/toy_end_to_end.py
Mühendislik Çıkarımı: Üretim ortamında LLM-as-a-Judge kullanırken modelin tek başına verdiği metrikleri mutlak gerçek kabul etmek ciddi yanılmalara yol açar. Özellikle belirsiz örnekleri insanlara yönlendirirken varyans patlamasına dikkat edilmeli ve Golden Dataset oluşturma süreçlerinde PPI++ gibi istatistiksel açıdan kanıtlanmış hibrit yöntemler tercih edilmelidir.
Kaynak ve atıf
Bu yazı, dev.to üzerinde yayımlanan içerikten yararlanılarak Edumints tarafından yapay zekâ desteğiyle Türkçe hazırlandı. Ayrıntılar ve yazarların kendi anlatımı için orijinaline bakabilirsin:
- dev.to/raihan-js/your-llm-judge-is-lying-to-you-a-little-1lke