Yerel LLM'ler İçin VRAM: Bellek Bant Genişliği Saniyedeki Token Hızınızı Neden Belirler?
İçindekiler
Yerel bir LLM çalıştırırken "Ne kadar VRAM gerekiyor?" sorusu yanlış bir başlangıç noktasıdır. Asıl sorulması gereken soru bu VRAM'in ne kadar hızlı olduğudur; çünkü metin üreten yerel bir model, ürettiği her bir token için ağırlıklarının tamamını bellekten okur. Bu durum, saniye başına gigabayt (GB/s) cinsinden bellek bant genişliğini, yerel kodlama ajanınızın hızla mı yazacağını yoksa sürükleneceğini mi belirleyen temel metrik yapar.
TL;DR
- Batch boyutu 1 olan üretim bellek bant genişliğine bağımlıdır: Yaklaşık tavan sınır
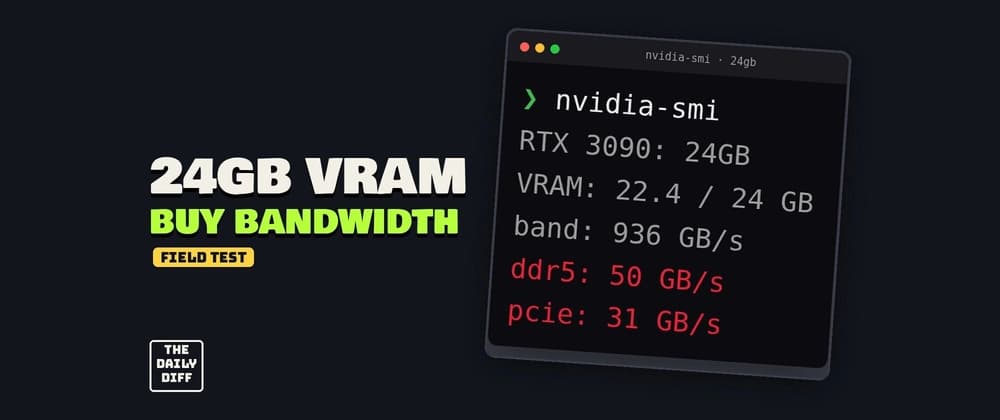
Bant Genişliği ÷ Model Boyutuile hesaplanır. 936 GB/s bant genişliğine sahip RTX 3090'da 10 GB'lık bir model saniyede en fazla ~90 tokene ulaşır. - Model taştığında bant genişliği 20 kat düşer: Model veya bağlam VRAM'e sığmadığında katmanlar PCIe 4.0 (31.5 GB/s) üzerinden DDR5 belleğe (~50 GB/s) taşar; 42.5 tok/s hız 3.8 tok/s seviyesine geriler.
- Kuantizasyon ve bağlam maliyeti: 4-bit ağırlıklar (KV cache hariç) 8B için ~5 GB, 14B için ~10 GB, 32B için ~20 GB ve 70B için ~40 GB yer kaplar. 32k token'lık bağlam buna birkaç gigabayt daha ekler.
- Fiyat/performans lideri: 384-bit veri yoluyla 24 GB sunan ikinci el RTX 3090 (650–750 $), dolar başına en yüksek bellek bant genişliğini sağlar.
Neden Yalnızca VRAM Boyutu Değil, Bellek Bant Genişliği LLM Hızını Belirler?
Oyunlar işlemci (compute-bound) odaklıdır; çekirdekler hızlandıkça kare hızı artar. LLM'lerin otoregresif çıkarımı ise tam tersidir. GPU, sonraki tokenı hesaplamak için modelin tüm ağırlıklarını VRAM'den geçirir, küçük bir matematiksel işlem yapar ve döngüyü tekrarlar. Çekirdekler çoğunlukla bellek veri yolunu bekler.
Pratik tavan formülü:
Maksimum token/sn ≈ Bellek bant genişliği (GB/s) ÷ Model boyutu (GB)
- RTX 3090, 4-bit 14B model (~10 GB): $936 / 10 \approx 94$ tok/s tavan hız.
- Aynı modelin DDR5'e taşması (~50 GB/s): $50 / 10 \approx 5$ tok/s tavan hız.
Gerçek testlerde hızlar tavanın altında kalsa da (3090'da 60–75 tok/s, DDR5'te 1.5–2 tok/s) oran değişmez: Ağırlıklar yer değiştirdiği için sistem 20 kat yavaşlar. 5.8 GHz Core i9 işlemci hız kazandırmaz; CPU yalnızca GPU'yu besler ve 6 çekirdekli bir Ryzen 5 fazlasıyla yeterlidir.
Seviyelere Göre GPU Bellek Bant Genişliği
Bant genişliğini pazarlama sınıfı değil, bellek tipi ve veri yolu genişliği belirler:
| Donanım | VRAM | Veri Yolu | Bant Genişliği | Pratikteki Durum |
|---|---|---|---|---|
| RTX 4060 Ti 16GB | 16 GB GDDR6 | 128-bit | 288 GB/s | Başlangıç kartı; 14B sığar |
| RTX 4070 Ti Super | 16 GB GDDR6X | 256-bit | 672 GB/s | Hızlıdır ancak 32B sığmaz |
| RTX 3090 (İkinci El) | 24 GB GDDR6X | 384-bit | 936 GB/s | 32B model ve bağlam için ideal |
| RTX 4090 | 24 GB GDDR6X | 384-bit | 1.008 GB/s | 3090 kapasitesinde, ~%8 daha hızlı |
| DDR5-6000 (Çift Kanal) | Sistem RAM | 128-bit | ~48–55 GB/s | Taşan katmanların gittiği yer |
| PCIe 4.0 x16 Bağlantısı | — | — | 31.5 GB/s | GPU ile RAM arasındaki darboğaz |
4060 Ti'ın 288 GB/s genişliği, 5 GB modelde ~58 tok/s teorik sınır sunar ve pratikte 42.5 tok/s üretir. 8B–14B için yeterli olsa da 32B için yetersiz kalır.
20 Katlık Uçurum: Bir Model VRAM'e Sığmadığında Ne Olur?
llama.cpp, Ollama ve vLLM sığmayan modelleri reddetmez; katmanları VRAM ile sistem belleği arasında böler. GPU kendi katmanlarını mikrosaniyede bitirip beklemeye geçer. RTX 4060 Ti'daki Llama 8B testinde model %100 VRAM'deyken 42.5 tok/s hız verirken, RAM'e taştığında bu hız 3.8 tok/s'ye çakılır.
Yazılım Geliştiriciler İçin Çıkarım: Yerel kodlama asistanı veya otonom ajan çalıştırırken model ağırlıklarının, KV cache'in ve bağlamın tamamen VRAM'de kaldığından emin olun. Tek bir katmanın bile DDR5'e taşması performansı 20 kat düşürür. Bu nedenle donanım bütçesini pahalı CPU'lara değil, 384-bit gibi geniş veri yoluna sahip yüksek VRAM'li GPU'lara ayırmalısınız.
Bu konuyu daha derinlemesine öğrenmek ister misin?
Edumints'teki ücretsiz kursları incele ve bugün başla.
Kurslara Göz At →