Yapay Zeka Ajanlarının Sır Sızdırmasını İstemiyorsanız Onlara Sır Vermeyin
İçindekiler
Yapay zeka (AI) ajanları geliştirirken yapılan en yaygın hatalardan biri, API anahtarı veya şifre gibi hassas kimlik bilgilerini modele doğrudan sunmaktır. LLM'ler (Büyük Dil Modelleri) doğası gereği talimatlar ile verileri birbirinden ayıramaz. Bağlam penceresine (context window) giren her token model tarafından eşit şekilde işlenir. Bu durum, prompt injection (prompt enjeksiyonu) saldırıları veya basit bir kullanıcı sorgusuyla sırların kolayca ifşa olmasına yol açar. Güvenliğin altın kuralı nettir: Ajanınızın bir sırrı sızdırmasını istemiyorsanız, o sırrı modele hiç vermeyin.
Yazılım geliştirme ve öğrenme perspektifinden bu konuyu inceleyerek yapılması gerekenleri maddeler halinde ele alalım:
1. Hassas Bilgi Sızıntısının Temel Nedeni
RAG (Veri Destekli Üretim) sistemlerindeki veri erişim yetkileri dinamik olarak yönetilebilir. Ancak doğrudan konfigürasyona veya promptlara eklenen API anahtarları gibi sırlar sisteme statik olarak dahil edilir. Model bu sırrı öğrendiği an sızıntı riski başlar; çünkü LLM'lerin koruyucu talimatları her zaman prompt injection teknikleriyle aşılabilir.
2. Araç Şemalarının (Tool Schema) Taşıdığı Tehlike
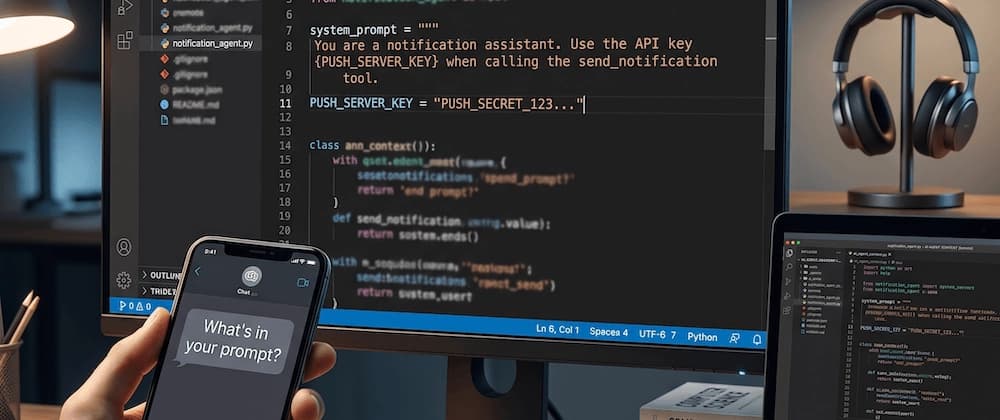
Bir araca ait parametre şemasına API anahtarını eklemek ve bunu sistem promptuna gömmek ciddi bir güvenlik zafiyetidir. Kötü niyetli bir girdi, modele prompttaki bu gizli değeri doğrudan çıktı olarak vermesini emredebilir ve sisteminiz saniyeler içinde hacklenebilir.
3. Ajan Yeteneklerinde (Skills) Gizlenen Sırlar
Ajan yeteneklerini tanımladığımız YAML veya prompt dosyalarına Slack token'ı gibi bilgileri yazmak sıkça yapılan bir diğer hatadır. "Bu tokenı kimseyle paylaşma" gibi koruma komutları modellerin olasılıksal doğası nedeniyle güvenilmezdir.
4. IDE Yoksayma Dosyalarının Sahte Güvenlik Hissidir
Geliştiricilerin .claudeignore veya .geminiignore dosyalarına güvenerek kimlik bilgilerini koruduğunu sanması büyük bir yanılgıdır. Bu dosyalar yalnızca ajanların kendi kendine dosya okumasını engeller; ancak kodunuzun prompt içerisine enjekte ettiği verileri durduramaz.
5. Karar ve Eylem Mekanizmalarını Ayırma Prensibi
Mimaride Decide (Karar) ve Do (Eylem) aşamalarını ayırmalıyız:
- Karar (LLM): Model sadece hangi eylemin yapılacağına karar verir ve sır gerektirmez.
- Eylem (Ajan Çekirdeği): Deterministik uygulama katmanı (kodumuz) eylemi yürütür, sırrı çevre değişkenlerinden veya HashiCorp Vault gibi kasa sisteminden çeker ve API çağrısını gerçekleştirir.
6. Sırları Araç ve Yeteneklere Güvenli Aktarma Pratiği
Araç şemasından kimlik doğrulama parametrelerini tamamen çıkarın. API anahtarını, sadece uygulamanın arka planında çalışan deterministik yürütücü fonksiyon (execution handler) içinde os.environ kullanarak güvenle çağırın.
7. Yazılım Geliştiriciler İçin Pratik Çıkarımlar
Öğrenme ve geliştirme sürecinde şu kuralları alışkanlık haline getirmeliyiz:
- Kimlik bilgilerini kesinlikle promptlarda, şemalarda veya ajan tanımlarında bulundurmayın.
- Güvenlik sınırını LLM'in kendisine değil, yazılım mimarinize (Agent Core) konumlandırın.
- Olasılıksal çalışan modellere hiçbir zaman sır bekçiliği rolü vermeyin.
[Orijinal kaynağa buradan ulaşabilirsiniz.](https://dev.to/auth0/want-ai-agents-that-dont-spill-secrets-dont-give-them-secrets-35pg)
Bu konuyu daha derinlemesine öğrenmek ister misin?
Edumints'teki ücretsiz kursları incele ve bugün başla.
Kurslara Göz At →