Tek Bir Ayar, 19 Kat Gecikme: Tek GPU Üzerinde vLLM Kıyaslamasından Öğrendiklerim
Kaynak: dev.to
İçindekiler 4 başlık
Yapılandırma başına gecikme (latency), işlem hacmi (throughput) ve çıktı sapmasını (output drift) ölçen küçük bir sunum test altyapısı (serving harness) kurulduğunda ortaya çarpıcı sonuçlar çıkabiliyor: Tek bir ayarda 19 katlık gecikme uçurumu, modeller arasında 3.6 katlık hız farkı ve temperature 0 değerinde bile kendi çıktılarını birebir üretemeyen bir akıl yürütme (reasoning) modeli.
Kapsam notu olarak; bu testler tek bir RTX 3060 GPU, iki model (Swallow-8B AWQ ve llm-jp-1.8B bf16), kısa istemler (prompts) ve gerçek üretim izleri yerine sentetik Poisson varış dağılımları kullanılarak gerçekleştirilmiştir. Çıktı sapması insan değerlendirmesiyle değil, birebir çıktı-hash eşleşmesiyle ölçülmüştür.
Nazik Kıyaslamalar (Benchmarks) Yalan Söyler#
İlk sürpriz max-num-seqs ayarında ortaya çıktı: 32 ve 128 değerleri, sabit eşzamanlılık (fixed-concurrency) ve standart Poisson yükleri altında birebir aynı sonuçları verdi. Sunucu hiç zorlanmadığı için bu parametre önemsiz gibi görünüyordu. Oysa sorun parametrede değil, test yükünün fazla "nazik" olmasındaydı.
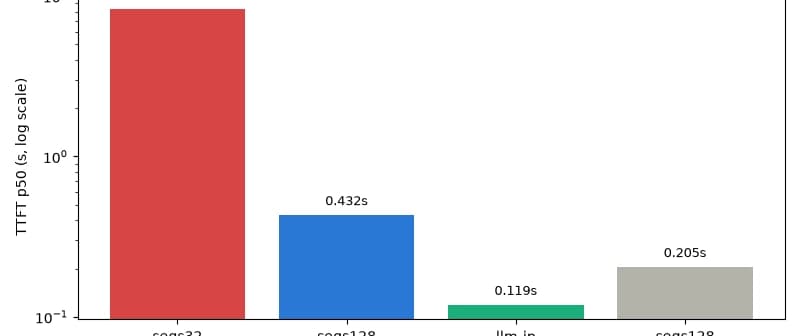
Sisteme bir stres kolu (64 eşzamanlı istek, 256 çıktı token'ı) eklendiğinde, aynı karşılaştırma TTFT (İlk Token'a Kadar Geçen Süre) p50 değerinde 8.3 saniyeye karşı 0.43 saniye sonucunu verdi. Aynı modeller, aynı istemler, tek bir parametre ve 19 kat fark. Bu sırada TPOT (Çıktı Token'ı Başına Süre) değeri 16–28 ms aralığında sabit kaldı; bu durum ders kitaplık bir ön-dolum (prefill) kuyruk birikmesidir.
- Pratik Çıkarım: Yapılandırma karşılaştırmaları mutlaka bir stres testi içermelidir. Kuyruğu doldurmayan nazik testler aslında boşta duran bir sunucuyu ölçer ve gerçek darboğazları gizler. Ayrıca üretim ortamlarında bu uçurum medyan (p50) değerinden önce p95 ve p99 kuyruk gecikmelerinde kendini gösterir.
Küçük Modeller Büyük Kazanır#
Aynı stres yükü altında farklı modeller karşılaştırıldığında: llm-jp-1.8B, 119 ms TTFT ve 28.5 istek/sn değerlerine ulaşırken; Swallow-8B, 432 ms TTFT ve 15.1 istek/sn seviyesinde kaldı. Yön şaşırtıcı olmasa da aradaki büyüklük farkı mimari seçimler için oldukça kritiktir.
- Geliştirici Notu: Dağıtım (deployment) aşamasında kullandığınız teknoloji yığınının alternatif yollarını iyi tanımalısınız. Örneğin, standart
transformerskütüphanesi llm-jp modelinin RoPE yapılandırmasında takılırken, model vLLM'in kendi çekirdekleri (kernels) altında sorunsuz çalışmaktadır.
Temperature 0 Deterministik Değildir (Akıl Yürütme Modelleri İçin)#
Kalite gerilemelerini yakalamak amacıyla her yapılandırmada hash'lenen 50 dondurulmuş istemlik kalite probu bambaşka bir sorunu ortaya çıkardı: Aynı Swallow sunucusu ve birebir aynı isteklerde, 50 çıktıdan 10'u çalıştırmadan çalıştırmaya farklılık gösterdi (sunucu yeniden başlatmalarında bu oran 50'de 12'ye çıktı). Aynı test düzeneğinde akıl yürütme özelliği olmayan (non-reasoning) bir model ise 3 kez üst üste birebir aynı sonuçları üretti.
- Pratik Çıkarım: Düşünme modu (think-mode) örneklemesi,
temperature 0ayarından sızmaktadır. Eğer üretim sisteminiz önbellekleme (caching), değerlendirme (eval) veya yeniden oynatma (replay) süreçleri için deterministik bir sunum varsayıyorsa, bunu varsaymak yerine her model için ayrı ayrı doğrulamalısınız.
Test Altyapısı (The Harness)#
Bu sonuçları yakalayan test altyapısı, GPU gerektirmeyen CI süreçleriyle entegre edilebilir hafif bir mimariye dayanmaktadır:
- İstemci ve Yük:
Asyncio+aiohttptabanlı istemci ile sabit ve Poisson yük üretimi. - Metrikler ve Kayıt: TTFT/TPOT için p50 ve p95 ölçümleri, hata oranları, her çalıştırma için JSONL çıktıları ve dondurulmuş kalite veri seti.
- İzolasyon ve CI: İstemci ve sunucu birbirinden bağımsız sanal ortamlarda (venv) yaşar; sahte bir SSE sunucusuna karşı koşulan 3 temel test, GPU'ya ihtiyaç duymadan doğrudan CI hattında çalışır.
Bu konuyu derinlemesine öğrenmek isterseniz: Ölçeklendirme ve Optimizasyon modülüne göz atın.
Kaynak ve atıf
Bu yazı, dev.to üzerinde yayımlanan içerikten yararlanılarak Edumints tarafından yapay zekâ desteğiyle Türkçe hazırlandı. Ayrıntılar ve yazarların kendi anlatımı için orijinaline bakabilirsin:
- dev.to/raihan-js/one-knob-19x-latency-what-i-learned-benchmarking-vllm-on-a-single-gpu-14bh