Saf JAX ile Gemma 4: Turing ve Ada Mimarileri Arasında Neler Değişiyor, Neler Değişmiyor?
İçindekiler
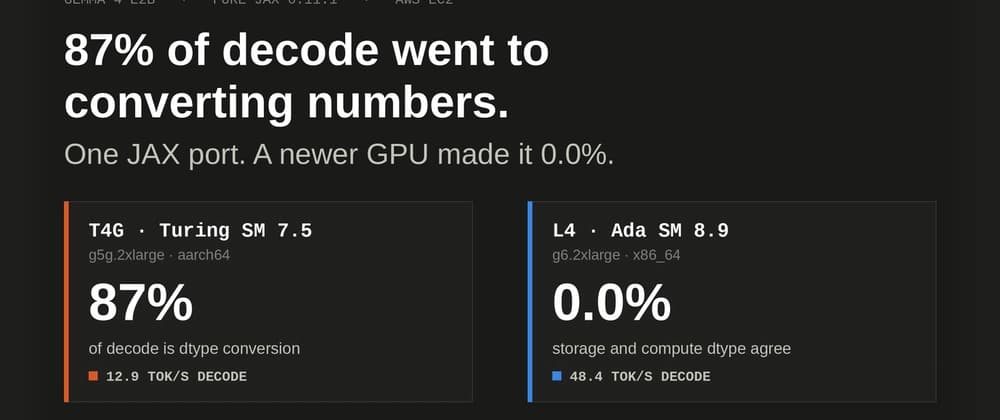
Bu rapor, saf JAX ile sıfırdan yazılmış bir Gemma 4 uygulamasının bir nesil fark bulunan iki NVIDIA GPU (Turing ve Ada) üzerindeki davranışını ve JAX soyutlamasının sızdığı noktaları inceliyor. Bu sızıntılardan biri, loglara hiçbir hata yansımadan decode süresinin %87'sini sessizce yok etmektedir.
Bu Makale Neyi Ölçüyor?
Tek bir kod tabanı, tek bir derleme ve aynı kontrol noktası ile iki kart karşılaştırılmıştır:
- G5g (Turing): NVIDIA T4G (SM 7.5, 15.360 MiB), Graviton2 aarch64 g5g.2xlarge spot,
float16veri tipi, JAX 0.11.1 (pip CUDA) ve2026-08-28-full-run-cached-g5gçalıştırması. - G6 (Ada): NVIDIA L4 (SM 8.9, 23.034 MiB), x86_64 g6.2xlarge spot,
bfloat16veri tipi, JAX 0.11.1 (Python 3.14) ve2026-08-28-first-serve-g6çalıştırması.
Her iki tarafta da google/gemma-4-E2B-it dense referans modeli ve ple4 + int8_lm_head konfigürasyonuyla 6.155.450.950 bayt ağırlık kullanılmıştır; yalnızca GPU çipi ve sunucusu farklıdır.
Başlamadan Önce Gerekenler
Ortamı kurmak ve test etmek için şu dört gereksinim yeterlidir:
- g5g.2xlarge ve g6.2xlarge spot kapasitesine sahip bir AWS hesabı
google/gemma-4-E2B-iterişimi olan bir Hugging Face token'ı- Sanal ortamsız, sistem genelinde kurulu Python 3.13 veya üstü
- CUDA toolkit, Rust toolchain veya derleyici gerekmez (hiçbiri zorunlu değildir)
Neden Saf JAX?
Model ports/gemma4/ altında OpenAI uyumlu bir sunucu arkasında çalıştırılır. PyTorch, vLLM veya torch_xla kullanılmaz. Temel amaç, aynı kaynak kodun konfigürasyon haricinde değişmeden her iki GPU mimarisinde de çalışabilmesidir.
Gemma 4 E2B Standart Bir Transformer Değildir
Herhangi bir port uygulamasının yönetmesi gereken dört zorunlu mimari farklılık vardır:
- İki Farklı Attention Geometrisi: Kayan (sliding) katmanlar
head_dim=256, global katmanlar512kullanır; standart inference motorları tek bir sabit boyut varsayar. - 8:1 MQA: KV bellek bütçesi toplam parametre sayısından bağımsız olarak oldukça küçüktür.
- KV-Share Haritası: 35 katmanı 15 önbelleğe indirgeyen katman paylaşım haritası.
- 512 Slotluk Kayan Halka: 512 slotluk kayan halka ve yükleme sırasında 4-bit nicelenen 4.70 GB'lık katman gömme tablosu.
Diğer Yığınları Bozan Şey Geometridir
Heterojen head boyutları vLLM gibi yığınları Triton attention backend'ine düşmeye zorlar. Turing mimarisinde Triton, donanım sınırını aşan paylaşımlı bellek (65.536 bayt donanım limitine karşılık 147.456 bayt istek) isteyerek OutOfResources hatası verir. JAX tarafında ise attention elle optimize edilen kernel yerine standart XLA ile derlendiğinden donanım paylaşımlı bellek tavanına takılmaz; karmaşık geometri burada sadece dizi boyutlarından ibarettir.
Birinci Sızıntı: dtype Politikası Cihazı Okumalıdır
En kritik mühendislik dersi: Yanlış hesaplama veri tipi (dtype) hata fırlatmaz, emüle edilir. Ampere öncesi Turing GPU'larda bfloat16, XLA tarafından sessizce fp32 üzerinden emüle edilir ve decode süresinin %87'si tür dönüştürme maliyetine harcanır. Loglarda hiçbir kırmızı hata görünmez. Pratik çıkarım: Model konfigürasyonunda dtype statik yazılmamalı, doğrudan çalışma anında donanım yeteneğine göre dinamik seçilmelidir.
Orijinal kaynağa buradan ulaşabilirsiniz.
Bu konuyu derinlemesine öğrenmek isterseniz: Ölçeklendirme ve Optimizasyon modülüne göz atın.
Bu konuyu daha derinlemesine öğrenmek ister misin?
Edumints'teki ücretsiz kursları incele ve bugün başla.
Kurslara Göz At →