RAG'de Sıralama ile Jev ile Yargılama Aynı Şey Değildir
İçindekiler
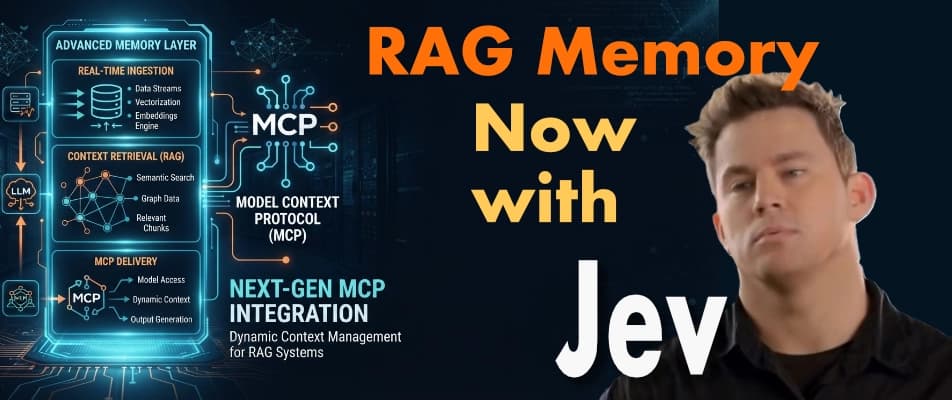
Geleneksel RAG (Retrieval-Augmented Generation) mimarilerinde en yaygın yanılgılardan biri, anlamsal veya sözcüksel benzerliği doğrudan "soruyu yanıtlama yeterliliği" ile eşdeğer görmektir. Zerikai Memory geliştiricisi Enrique'nin deneyimi, konusal yakınlık ile gerçek alaka düzeyini birbirinden ayırmanın kritik önemini ortaya koyuyor. Getirilen parçaları yalnızca sıralamak yerine, enjeksiyon riskleri ve çelişkilerden arındırarak yargılamak (judging), IDE ajanlarına derin bir yapısal farkındalık kazandırır. Bu süreçte TypeSafe'in yeni yargı modeli Jev, sentezleyici LLM'e yalnızca gerçekten değerli kod parçalarının iletilmesini sağlar.
1. Sıralama ile Yargılama Aynı Şey Değildir
Zerikai Memory, Tree-sitter ile kod tabanını deterministik olarak ayrıştırıp fonksiyon ve sınıfları yerel bir ChromaDB deposuna aktaran güçlü bir getirme (retrieval) çekirdeğine sahiptir. Sorgu anında L2 mesafesi ve sözcüksel yeniden sıralama (lexical re-ranking) ile adaylar listelenir. Ancak standart RAG boru hatlarında olduğu gibi, sözcüksel yeniden sıralama yalnızca adayları kelime örtüşmesine göre yeniden dizer; onları yargılayamaz veya uygunsuz olanları eleyemez.
Sorguyla yalnızca ortak terimleri paylaşan ama soruyu çözmeyen parçalar da sentezleyici modele ulaşır. Bu durum, modelin kaynaklarda bulunmayan varsayımlar üretmesine (halüsinasyon) zemin hazırlayabilir. Jev bu boşluğu doldurur: Mevcut yapının yerine geçmek yerine, getirme katmanına bir denetçi ekler. Parçaların sadece benzerliğini değil; soruyu doğrudan yanıtlayıp yanıtlamadığını, salt yüzeysel bir yakınlık mı taşıdığını ve modeli manipüle etmeye yönelik bir risk içerip içermediğini yargılar.
2. Zerikai Memory Hakkında Biraz Daha Bağlam
Zerikai Memory, IDE ajanları için çalışma alanına özel, kalıcı ve yerel öncelikli (local-first) bir bellek katmanıdır. Mimarisi şu temel hedefler üzerine kuruludur:
- Deterministik İndeksleme: Tree-sitter; imza, satır numarası ve docstring'leri token veya ağ maliyeti olmadan ayrıştırır.
- Yerel MCP Arayüzü: Ajan, Model Context Protocol (stdio) üzerinden iletişim kurarak bağlamı geliştiricinin yerel makinesinde toplar.
- Düşük Maliyetli Sentez: Yapılandırılmış bağlam, yerel Ollama modelleri veya DeepSeek gibi uygun maliyetli API'lerle uyumludur; KV-cache verimini maksimize eder.
- Sıkı Kaynak Doğrulaması: Her yanıt belirli bir varlık, dosya ve satır numarasına kesin L2 mesafesiyle çıpalanır.
Sorgu akışı ChromaDB → L2 Getirme → Sözcüksel Yeniden Sıralama → LLM Sentezi → IDE Ajanı şeklindedir. Buradaki kritik eksiklik, sıralama katmanının yalnızca "Bu parça ilgili mi?" sorusunu sorması ve bunu parçaların yerini değiştirerek yanıtlamasıydı. Bir parçanın "ilgili" görünmesinden "soruyu gerçekten yanıtladığına" geçiş hiçbir zaman doğrulanmıyordu.
3. TypeSafe Jev'e Giriş
TypeSafe Jev, RAG hattına tam da bu noktada dahil olur. Yazılım geliştiricileri açısından temel pratik çıkarım şudur: Sıralama algoritmaları bağlam penceresini gereksiz veya yanıltıcı verilerle doldurabilir. Aday parçaları LLM sentez katmanına göndermeden önce özel bir yargı modeli (judgment model) ile filtrelemek; token maliyetlerini düşürür, bağlam zehirlenmesini önler ve ajanların doğrulanabilir kod referanslarıyla güvenilir çalışmasını sağlar.
Orijinal kaynağa buradan ulaşabilirsiniz.
Bu konuyu derinlemesine öğrenmek isterseniz: Reranking Modelleri: Serving ve Entegrasyon modülüne göz atın.
Bu konuyu daha derinlemesine öğrenmek ister misin?
Edumints'teki ücretsiz kursları incele ve bugün başla.
Kurslara Göz At →