RAG Sistemleri İçin Amazon OpenSearch Vektör Araması Rehberi
İçindekiler
RAG Sistemi Nedir, Kısaca?
Retrieval-Augmented Generation (RAG), büyük dil modellerinin (LLM) harici verilerle beslenerek daha doğru yanıtlar vermesini sağlayan bir mimaridir. Temelde arama (retrieval) ve üretim (generation) adımlarından oluşur. Geliştiriciler olarak, arama aşamasının doğruluğunun tüm sistemin çıktı kalitesini doğrudan etkilediğini bilmeliyiz.
Neden Vektör Araması?
Klasik anahtar kelime aramaları anlam eşleşmelerini ("araba" yerine "otomobil") kaçırabilir. Vektör araması ise kelimeleri anlamlarına göre embedding (sayısal vektörler) haline getirir. OpenSearch, en yakın komşu (k-NN) özelliği sayesinde bu anlamsal aramaları milyonlarca veri üzerinde milisaniyeler içinde gerçekleştirebilir.
Amazon OpenSearch Vektör Aramasını Nasıl Gerçekleştirir?
OpenSearch, tam ve yaklaşık (ANN) en yakın komşu araması yöntemlerini sunar. Üretim ortamlarında hız için ANN tercih edilir. OpenSearch üç motoru destekler:
- FAISS: HNSW ve IVF algoritmalarını destekler; büyük veriler için idealdir.
- Lucene: Yerleşik verimli filtreleme sunar; küçük ve orta ölçekli projeler için uygundur.
- NMSLIB: Artık kullanımdan kaldırılmıştır (deprecated), yeni projelerde tercih edilmemelidir.
Geliştiriciler için pratik çıkarım: Yeni projelerinizde FAISS veya Lucene motorlarını kullanın.
RAG Sistemimizin Mimarisi
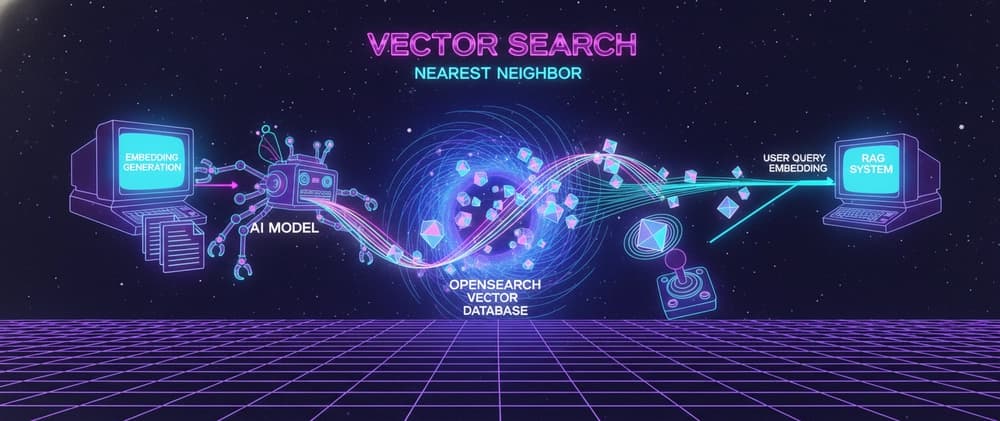
Mimari, veri yükleme (ingestion) ve sorgulama (query) yollarından oluşur. Burada en kritik kural, hem verileri kaydederken hem de kullanıcı sorgusunu ararken tamamen aynı embedding modelini kullanmaktır. Farklı modellerin çıktıları kıyaslanamaz.
Veri Modeli
Dokümanlar bütün halinde saklanmaz; anlamlı küçük parçalara (chunks) bölünür. Her parça; metin, metadata ve vektör olarak saklanır. Bu yapı, LLM prompt'larının bağlam limitlerine sığması için hayati önem taşır.
Uygulamalı Kılavuz
- OpenSearch'ü Yerel Çalıştırma: Docker komutu ile
OPENSEARCH_INITIAL_ADMIN_PASSWORDbelirlenerek cluster kurulur. - k-NN İndeksi Oluşturma: FAISS motoru ve HNSW parametreleri (
m,ef_construction,space_type) tanımlanır. - Belgeleri Bağlama ve İndeksleme: Python'da
opensearch-pyvesentence-transformersile belgeler vektörleştirilip bulk olarak yüklenir. - Sorgu Vektörüyle Arama: Kullanıcı sorusu vektöre dönüştürülüp k-NN araması ile en benzer içerikler bulunur.
- RAG Prompt Oluşturma: Elde edilen sonuçlar bir bağlam şablonunda birleştirilerek LLM'e sunulacak hale getirilir.
Amazon OpenSearch Service ile Çalıştırma
Yerel kodunuzu AWS ortamına taşırken sadece istemci bağlantı ayarlarını (IAM ve AWSV4SignerAuth ile) güncellemeniz yeterlidir; indeksleme ve sorgu kodları tamamen aynı kalır.
Üretim Ortamı İçin Pratik Notlar
- Doğru embedding modelini seçmek arama başarısını doğrudan etkiler.
- Belgeleri doğru chunk boyutlarında bölmek (chunking) hassasiyeti artırır.
- Filtreleme ihtiyaçlarında FAISS veya Lucene'in yerleşik filtreleme yeteneklerini kullanın.
- Vektörler RAM'de tutulduğu için bellek takibi yapın; quantization (nicemleme) yöntemlerini araştırın.
Sonuç
Amazon OpenSearch, yerel ortamdan AWS bulutuna kolayca taşınabilen yapısıyla RAG sistemleri için esnek ve güçlü bir vektör veri tabanı sunar.
Orijinal makaleye buradan ulaşabilirsiniz.
Bu konuyu daha derinlemesine öğrenmek ister misin?
Edumints'teki ücretsiz kursları incele ve bugün başla.
Kurslara Göz At →