PyTorch Nasıl Her Yapay Zeka Çipinin Takıldığı Ortak Soket Haline Geldi?
Kaynak: dev.to
İçindekiler 3 başlık
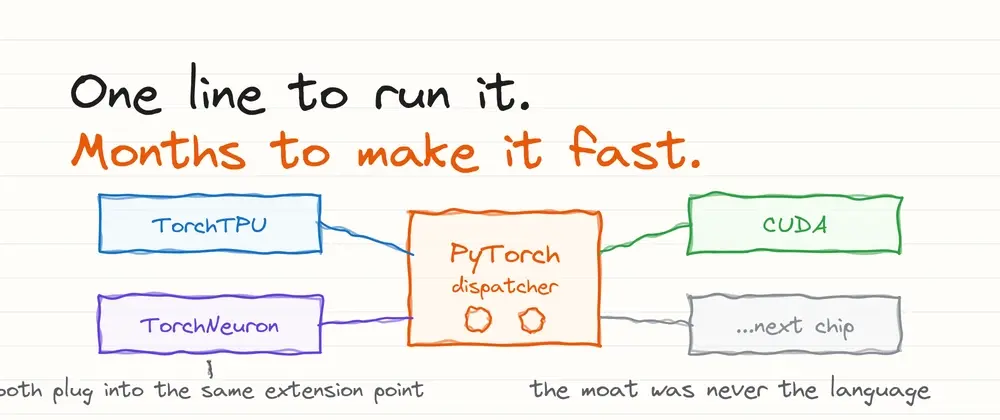
19 Ekim'de AWS, PyTorch'un kendi Trainium çipleri üzerinde doğrudan çalışmasını sağlayan TorchNeuron'u yayınladı. Bir gün sonra Google ve Meta, Google'ın TPU'ları için aynı işi yapan TorchTPU'yu duyurdu. Her iki araç da PyTorch Konferansı'nda tanıtıldı, her ikisi de açık kaynaklı ve her ikisi de PyTorch'a aynı küçük kanca (hook) üzerinden bağlanıyor.
Asıl hikaye tam olarak bu son noktada yatıyor. Birbirleriyle koordinasyon kurmak için hiçbir nedeni olmayan iki dev şirket aynı sonuca vardı: Çalışan bir mühendisin dizüstü bilgisayarına giden yol, PyTorch içindeki tek bir genişletme noktasından geçiyor.
.to("cuda") Çağırdığınızda Ne Olur?#
İki tensör üzerinde a + b yazdığınızda PyTorch hemen toplama işlemi yapmaz. Bir tabloda aten::add adını arar. Bu aramayı yapan bileşene dispatcher (dağıtıcı) denir. Tensörlerin nerede yaşadığına bakar, üzerlerindeki etiketi (CPU, CUDA vb.) okur ve işlemi o donanımda gerçekleştirecek olan özel fonksiyonu seçer.
Donanıma özgü bu fonksiyonlara kernel (çekirdek), tek bir etiket altında toplanmış eksiksiz çekirdek setine ise backend (arka uç) denir. PyTorch, PrivateUse1 adlı bir etiketi kasıtlı olarak boş bırakır. Herhangi bir donanım üreticisi, kodunun doğrudan PyTorch ana deposuna kabul edilmesine gerek kalmadan kendi deposundan bu etiketi sahiplenebilir ve çekirdeklerini buraya kaydedebilir. TorchTPU ve TorchNeuron tam olarak bu kayıt mekanizmasını kullanır. Böylece yeni bir çip yeni bir etikete dönüşür ve kodunuzda sadece model.to("tpu") yazmanız yeterli olur.
Bu mimari, çok daha hantal olan eski bir yöntemin yerini alıyor. Eskiden TPU'lar üzerinde PyTorch çalıştırmak, Google'ın diğer çatısı olan JAX üzerinden geçmeyi gerektiriyordu. TorchTPU ekibi eski yaklaşımın "PyTorch'u JAX'ın çalışma mantığına zorla sığdırdığını" açıkça belirtiyor. Yeni arka uçta çalışma zamanında (runtime) JAX bulunmuyor ve işlemler yazdığınız anda tek tek çalıştırılıyor; ki çoğu geliştirici hata ayıklamayı (debugging) tam olarak böyle yapar. Artık çip önce tercüme edilmek yerine doğrudan PyTorch dili konuşuyor.
Kapsama alanı da oldukça gerçekçi görünüyor. Google, Hugging Face'ten 4.917 modeli test etti: %98'i çökmeden çalıştı ve yakından incelenenlerin %97'si bir GPU ile aynı sayısal sonuçları üretti. Amazon ise TorchNeuron'u her derlemede yüz binlerce modele karşı test ettiğini belirtiyor.
Çalıştırmak İşin Kolay Yarısı#
TorchTPU ekibinin kendi ifadeleriyle (uyarıları dahil) durum şöyledir: "Bir iş yükünü TPU'ya taşımak model.to("cuda") ifadesini model.to("tpu") olarak değiştirmek kadar basit olmalıdır. (Bu basit değişiklikle maksimum TPU performansına ulaşılamaz... ancak model kutudan çıktığı gibi çalışmalıdır.)" Parantez içindeki kısım, asıl mühendislik mesaisinin harcandığı yerdir. Dikkat edilmesi gereken 4 temel fark şunlardır:
- Sayılar farklı çıkar: CUDA üzerinde PyTorch, varsayılan olarak tam 32-bit hassasiyetle (precision) çarpma işlemi yapar. TorchTPU ise varsayılan olarak daha hızlı ancak daha düşük hassasiyetli bir moda geçer. Modeliniz çalışır ancak çıktılarında sapmalar (drift) görülebilir.
- Varsayılan ağ ayarları hızınızın üçte birine mal olur: TorchTPU, "Skinny Collectives" adlı bir seçenek açık olarak gelir. Google, çiplerin eğitim sırasında sonuçları birbirine aktarma yöntemi olan bu ayarın uçtan uca %30–40 performans kaybına yol açabileceğini söylüyor.
- Henüz her işlem mevcut değildir: PyTorch'un yerleşik işlemlerinin yaklaşık 450 tanesi desteklenmektedir. Örneğin Google'ın kendi örneklerinden birinde
FlexAttentionhenüz desteklenmiyordu. - İşlem (process) yerleşimi değişir: JAX makine başına bir işlem çalıştırırken, TorchTPU çip başına bir işlem çalıştırır. Bir çipi farklı görevler arasında paylaştıran pekiştirmeli öğrenme (reinforcement learning) kurulumları bu durumdan doğrudan etkilenir.
Geliştiriciler İçin Pratik Çıkarımlar#
Yazılım mühendisliği ve MLOps perspektifinden bu gelişme, soyutlama katmanlarının (abstraction layers) gücünü kanıtlıyor. Kodunuzu donanımdan bağımsız hale getirmek harika bir başlangıç olsa da, üretim ortamında Ölçeklendirme ve Optimizasyon yaparken donanımın varsayılan hassasiyet (precision) ve iletişim (collectives) davranışlarını bilmek zorundasınız. Bir modeli yeni bir çipe taşırken sadece kodun çökmemesine değil, sayısal sapmalara ve darboğazlara karşı doğrulama testlerine odaklanmalısınız.
Kaynak ve atıf
Bu yazı, dev.to üzerinde yayımlanan içerikten yararlanılarak Edumints tarafından yapay zekâ desteğiyle Türkçe hazırlandı. Ayrıntılar ve yazarların kendi anlatımı için orijinaline bakabilirsin:
- dev.to/dhruv1206/how-pytorch-became-the-socket-every-ai-chip-plugs-into-38m4