NVIDIA Dynamo ile Ayrıştırılmış Çıkarım (Disaggregated Inference) Mimarisi Oluşturma
Kaynak: dev.to
İçindekiler 8 başlık
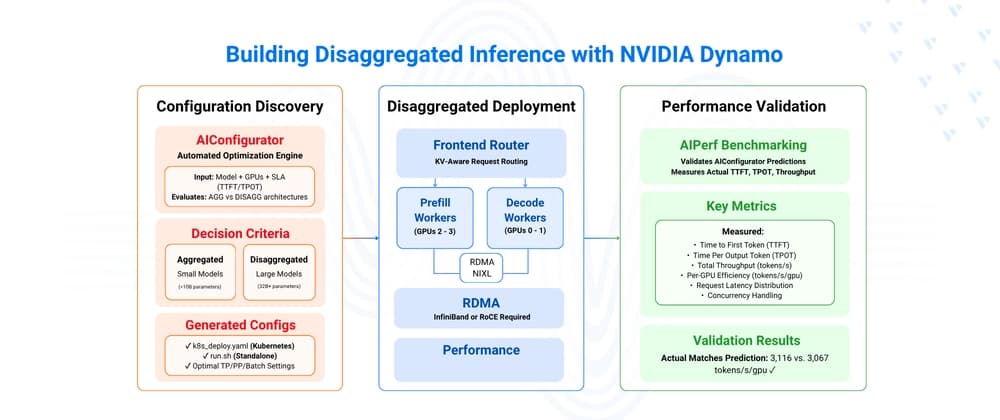
NVIDIA Dynamo, büyük ölçekli üretken yapay zeka modellerini çok düğümlü (multi-node) ve çoklu GPU ortamlarında dağıtmak için geliştirilmiş açık kaynaklı bir çıkarım (inference) çerçevesidir. Ayrıştırılmış sunum (disaggregated serving) mimarisi, istem işleme (prefill) ve token üretme (decode) aşamalarını farklı GPU çalışanlarına (workers) ayırarak her aşamanın kendi hesaplama karakteristiğine göre bağımsız ölçeklenmesini ve optimize edilmesini sağlar.
Bu rehber; AIConfigurator ile en uygun yapılandırmayı keşfetmeyi, RDMA destekli Kubernetes üzerinde dağıtım yapmayı ve AIPerf ile performansı doğrulamayı kapsar. Büyük modellerde (32B+) ve uzun girdi bağlamlarında ayrıştırılmış mimari, birleşik sunuma kıyasla 1.7 kata kadar iş hacmi (throughput) artışı sağlar; daha küçük modellerde ise AIConfigurator birleşik sunumun ne zaman daha verimli olduğunu otomatik olarak belirler. Mühendislik ve Ölçeklendirme ve Optimizasyon perspektifinden bu yaklaşım, donanım darboğazlarını aşarak maliyet-performans dengesini kurmanın anahtarıdır.
Ön Koşullar#
Başlamadan önce aşağıdaki ortamlardan birine sahip olduğunuzdan emin olun:
Kubernetes Dağıtımı İçin:#
- NVIDIA GPU düğümlerine ve kurulu RDMA cihaz eklentisine sahip bir Kubernetes kümesi.
- Kümenize erişmek için yapılandırılmış
kubectl. - RDMA destekli bir ağ (InfiniBand veya RoCE).
- Dynamo Operatörü ve GPU kaynak yönetimi yapılandırılmış olarak kümenizde kurulu NVIDIA Dynamo platformu.
Tekil Sunucu (Standalone) Dağıtımı İçin:#
- NVIDIA GPU'lara ve yapılandırılmış NVIDIA Container Toolkit'e sahip GPU destekli bir sunucu.
- Ayrıştırılmış sunum için 2 veya daha fazla GPU.
- Docker Engine ve Docker Compose.
sudoyetkilerine sahip root olmayan bir kullanıcı.
Ortak Gereksinimler:#
- AIConfigurator çalıştırmak için Python 3.10+.
- Kısıtlı (gated) modeller için erişim anahtarına (access token) sahip bir Hugging Face hesabı.
Ayrıştırılmış Sunum Mimarisini Anlamak#
Ayrıştırılmış sunum, LLM çıkarım sürecini farklı hesaplama özelliklerine göre optimize edilmiş iki uzmanlaşmış aşamaya böler.
Prefill Aşaması ve Decode Aşaması Karşılaştırması#
- Prefill: Tüm girdi istemini paralel olarak işler. Bellek bant genişliğine bağımlıdır (memory-bound), yüksek bant genişlikli GPU'lardan yararlanır ve düşük yığın boyutları (batch size 1-4) kullanır.
- Decode: Token'ları sırayla, her seferinde bir tane üretir. Hesaplama gücüne bağımlıdır (compute-bound), yüksek eşzamanlılıktan yararlanır ve yüksek yığın boyutları (batch size 256-1024) kullanır.
Mimari Bileşenleri#
Prefill Çalışanları (Workers):
- Gelen istemleri işler ve KV önbelleği (KV cache) üretir.
- Optimal ilk token süresi (TTFT) için düşük yığın boyutlarıyla çalışır.
- Decode çalışanlarından farklı tensör paralelliği (TP) kullanabilir.
- KV önbelleğini NIXL aracılığıyla decode çalışanlarına aktarır.
Decode Çalışanları (Workers):
- Prefill çalışanlarından KV önbelleğini alır.
- Çıktı token'larını sırasıyla üretir.
- Büyük yığın boyutlarıyla yüksek eşzamanlılığı yönetir.
- Sürdürülebilir token iş hacmi (throughput) için optimize edilmiştir.
İstek Yönlendirme (Request Routing):
- Ön yüz (Frontend), istekleri uygun prefill çalışanlarına yönlendirir.
- PrefillRouter, KV önbellek yakınlığına (affinity) göre prefill çalışanlarını seçer.
- Prefill işleminden sonra decode çalışanları KV önbelleğini alır ve üretime devam eder.
- NIXL, RDMA ile GPU'dan GPU'ya KV önbellek aktarımını sağlar.
Ayrıştırılmış Sunum Ne Zaman Kullanılmalı?#
Aşağıdaki durumlarda ayrıştırılmış sunumu tercih edin:
- Model boyutu büyük olduğunda (32B+ parametre) — daha küçük modellerde KV önbellek aktarım yükü düşüktür ve aşama ayrımını gerektirmeyebilir.
- Girdi dizi uzunluğu (ISL), çıktı dizi uzunluğunu (OSL) önemli ölçüde aştığında — tipik olarak 4000 token üzerindeki ISL değerlerinde.
- İş yükü, prefill ve decode kapasitesinin bağımsız olarak ölçeklenmesini gerektirdiğinde.
- RDMA destekli ağ altyapısı mevcut olduğunda (pratikte yüksek hızlı GPU'lar arası iletişim gecikmeyi önlemek için şarttır).
Kaynak ve atıf
Bu yazı, dev.to üzerinde yayımlanan içerikten yararlanılarak Edumints tarafından yapay zekâ desteğiyle Türkçe hazırlandı. Ayrıntılar ve yazarların kendi anlatımı için orijinaline bakabilirsin:
- dev.to/vultr/building-disaggregated-inference-with-nvidia-dynamo-5fn8