LLM Wiki'mizde Vektör Arama Kullanmalı mıyız? Karar Vermeden Önce Benchmark Testi Yaptık
Kaynak: dev.to
İçindekiler 2 başlık
Her "vektör arama ekleyelim" önerisi aynı vaatle gelir: kullanıcılar soruları kendi cümleleriyle sorar, anahtar kelime araması bunları kaçırır ve embedding'ler (vektör temsilleri) sorunu çözer. Synthadoc projesine gelen bir özellik talebi (#411) tam olarak bu argümanı savunuyordu:
Synthadoc yalnızca BM25 kullanıyor. 200 sayfanın altındaki wiki'ler için BM25 hızlı ve kesindir; ancak 500+ sayfada, farklı kelimelerle ifade edilen (paraphrase) ve kavramsal sorgular anlamsal (semantic) bir katman olmadan giderek daha fazla hedefi ıskalıyor.
Talep ayrıca embedding'lerin varsayılan olarak açık gelmesini istiyordu. pip ile kurulan bir araç için bu büyük bir mimari değişikliktir. Bu nedenle tek satır arama kodu yazmadan önce üç temel soruyu yanıtlamak için kapsamlı bir benchmark oluşturduk:
- Bir wiki büyüdükçe BM25 gerçekten farklı kelimelerle sorulan sorularda kötüleşiyor mu?
- Halihazırda sunduğumuz (varsayılan olarak kapalı olan) vektör arama bunu çözüyor mu?
- Çözmüyorsa, hangi tasarım çözer ve ne kadar iyileştirme sağlar?
Benchmark Bulguları ve Mimari Çıkarımlar#
- Evet, anahtar kelime araması wiki boyutuyla kötüleşiyor — ama yalnızca dolaylı ifadelerde: 2.000 sayfalık bir wiki'de BM25, farklı kelimelerle sorulan soruların %48'inde doğru sayfayı ilk 5'e sokabildi (200 sayfada bu oran %71'di). Sayfanın kendi kelimelerini veya tam isimleri kullanan sorgular ise her boyutta ~%99–100 başarısını korudu.
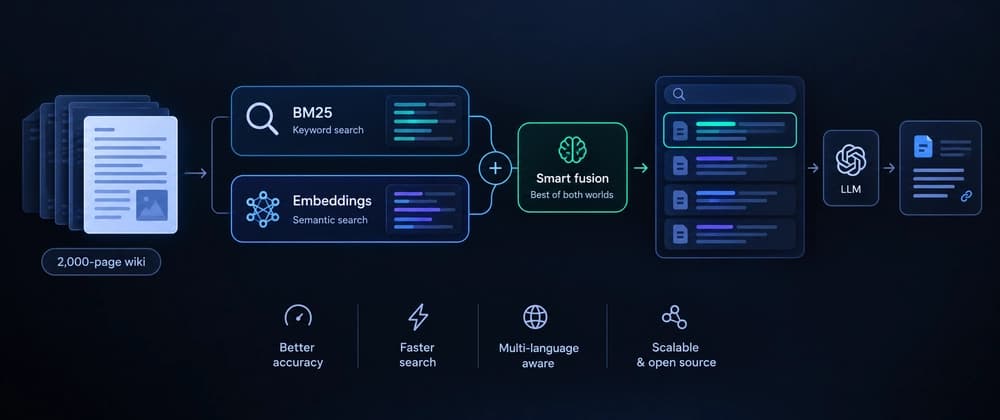
- Mevcut "vektör yeniden sıralama (re-rank)" modumuz aramayı genel olarak daha kötü hale getirecekti: Dolaylı ifadeleri iyileştirdi (%48 → %60) ancak tam isim aramalarını mahvetti (%99 → %63). Bu da genel başarıda %84'ten %74'e net bir düşüş yarattı. İki sıralamayı birleştirmek (hibrit füzyon) dolaylı soruları düzeltti (%48 → %69), fakat tam isim aramaları yine %94'e geriledi. Aradaki farkı tek bir kural kapattı: BM25'in açık bir kazananı olduğunda (en iyi skoru bir sonrakinden en az %5 öndeyse), BM25'in en üst sonuçlarını zirvede tut. 2.000 sayfadaki nihai sonuç: dolaylı ifadeler %48 → %68, tam isimler %99 → %98, sayfanın kendi kelimeleri %100 → %100, genel başarı %84 → %90 oldu.
- Bonus — İndeks önbellekleme (caching): Benchmark süreci, BM25'in her sorguda indeksini baştan oluşturduğunu ortaya çıkardı. Bunu önbelleğe almak, anahtar kelime aramasını tüm kullanıcılar için 18 kat hızlandırdı (P95 gecikmesi 362 ms → 20 ms).
- Hiç ayarlama yapmadığımız verilerde de başarısını korudu: İnsan tarafından yazılmış İngilizce sorgularda anlamsal arama her ölçütte daha iyiydi. Ancak Çince'de daha kötü sonuç verdi çünkü embedding modelimiz yalnızca İngilizce eğitilmişti. Bu yüzden Çince, Japonca ve Korece sayfalar artık otomatik olarak anahtar kelime aramasında kalıyor.
- Varsayılan olarak açık ve paralel çalışıyor: Yeni wiki'lerde
vector = "auto"artık varsayılan. Ayrıca sorgu embedding'ini BM25'ten sonra değil, onunla paralel çalıştırmak anlamsal arama süresini 166 ms'den 62 ms'ye (P95, 2.000 sayfa) düşürdü. - Bilgi grafiği (Knowledge Graph) ölçekleme sorunu çözüldü: 5.000 sayfada grafik görünümünün açılması 34 saniye sürüyor ve tarayıcıyı donduruyordu. Artık küme (cluster) genel görünümüyle yaklaşık 6 saniyede açılıyor ve akıcı şekilde 60 fps'de çalışıyor.
Arka Plan: Synthadoc Bugün Sayfaları Nasıl Buluyor?#
Synthadoc; PDF'leri, web sayfalarını ve notları Markdown tabanlı bir wiki'ye derleyen, ardından bu wiki üzerinden atıflarla (citations) soruları yanıtlayan açık kaynaklı bir araçtır. Yanıt kalitesi neredeyse tamamen tek bir adıma bağlıdır: LLM'e verilecek doğru sayfaları bulmak.
Bugün bu adım, nöral arama öncesindeki çoğu arama motorunun arkasındaki klasik anahtar kelime sıralama fonksiyonu olan BM25 ile yürütülüyor. BM25, sayfaları sorgudaki kelimelerin kaçını içerdiğine göre puanlar ve nadir kelimelere daha fazla ağırlık verir. Hızlıdır, model gerektirmez ve kullanıcı sayfayla aynı kelimeleri kullandığında mükemmeldir. Ayrıca isteğe bağlı bir [search] vector = true ayarı da sunuyoruz.
Geliştiriciler İçin Pratik Ders: RAG ve arama sistemlerinde ("Embedding Model Serving Temelleri" ve "Reranking Modelleri: Serving ve Entegrasyon" modüllerimizde de vurgulandığı gibi) doğrudan vektör aramaya geçmek her zaman net kazanç sağlamaz. Üretim ortamında en iyi sonuç; sağlam bir değerlendirme (benchmark) kurgusu, önbellekleme optimizasyonu ve kesin eşleşmeleri koruyan kural tabanlı hibrit arama mimarisiyle elde edilir.
Kaynak ve atıf
Bu yazı, dev.to üzerinde yayımlanan içerikten yararlanılarak Edumints tarafından yapay zekâ desteğiyle Türkçe hazırlandı. Ayrıntılar ve yazarların kendi anlatımı için orijinaline bakabilirsin:
- dev.to/peter-white-1492/should-our-llm-wiki-use-vector-search-we-benchmarked-it-before-deciding-fkf