LLM Sunumunda g5g ve g6 Karşılaştırması: Aynı Kod ile 3.7 Kat Daha Fazla Throughput
İçindekiler
Bu makale, küçük bir dil modelini (SLM) sunarken iki AWS GPU sunucu ailesini, her iki tarafta da bayt düzeyinde tamamen özdeş bir iş yükü kullanarak karşılaştırıyor. Yapılan testlerde eski nesil sunucu ailesi (g5g), kod çözme (decode) süresinin %87'sini veri tipi (dtype) dönüşümlerine harcıyor; üstelik hiçbir sistem günlüğü, metrik veya sistem kontrolü bu gizli darboğazı bildirmiyor.
İki Bulut Sunucusu (The Two Instances)
Karşılaştırmada AWS üzerinde Spot modeliyle çalışan iki farklı yapılandırma ele alınmıştır:
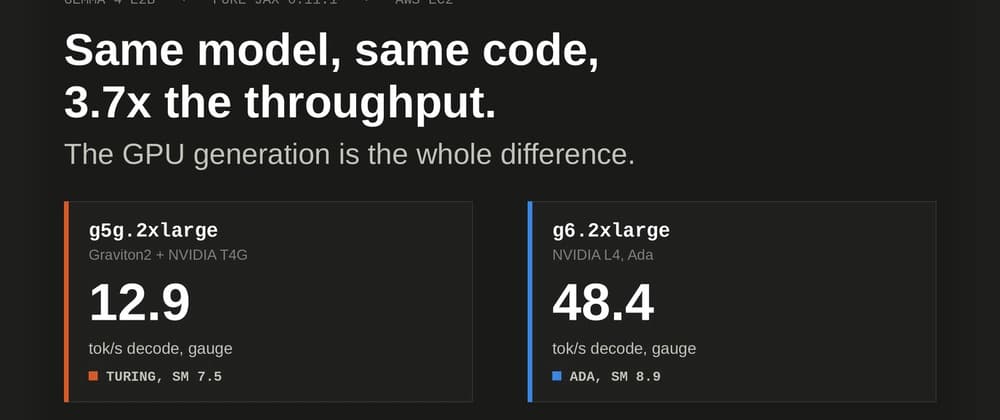
- g5g.2xlarge: Graviton2 (aarch64) işlemci ve NVIDIA T4G GPU (Turing mimarisi, SM 7.5, 15.360 MiB bellek).
- g6.2xlarge: x86_64 işlemci ve NVIDIA L4 GPU (Ada Lovelace mimarisi, SM 8.9, 23.034 MiB bellek).
İş yükü olarak, saf JAX ile geliştirilmiş google/gemma-4-E2B-it referans ağırlığı kullanılmıştır (PyTorch, vLLM veya torch_xla içermez). Her iki tarafta da derleme kimliği (51bc52c9e2e9), ple4 + int8_lm_head yapılandırması ve 6.155.450.950 baytlık model ağırlıkları birebir aynıdır; tek değişken ana işlemci ve GPU mimarisidir.
Bu Aşamada Sahip Olmanız Gerekenler
- g5g.2xlarge ve g6.2xlarge için Spot kapasitesi,
google/gemma-4-E2B-iterişimine sahip bir Hugging Face token'ı,- Donanım mimarisine uygun Derin Öğrenme AMI'si (aarch64 ve x86_64 imajları birbiriyle uyumsuzdur),
- CUDA toolkit veya Rust derleyicisine gerek yoktur;
jax[cuda13]CUDA bağımlılıklarını tekerlek (wheel) paketleri halinde sunar.
Kurulum Sadece Bir pip Kurulumudur
Her iki makinede de kaynak koddan derleme adımı yoktur. jax[cuda13], Graviton2 aarch64 mimarisi dahil tekerlek paketlerini doğrudan kurar. XLA derleme önbelleği S3'e yedeklenip açılışta hızla geri yüklenir; g5g kurulumunda önceden sonlandırılmış bir makineden 805 dosya (12 MB) sadece 6 saniyede çekilerek toplam kurulum önbellek dahil 117 saniyede tamamlanır.
Herhangi Bir Şey Ölçmeden Önce Isınma Yapın
max_new_tokens statik bir argüman olduğundan (bucket, max_tokens) derleme şeklini belirler. İlk istek doğrudan XLA derleme maliyetine takılır. g5g üzerinde ilk istek 18.06 saniye sürerken ısınmış istek 4.50 saniyede tamamlanmıştır (4 kat fark). Isınma adımını atlayan kıyaslama testleri, sunucunun gerçek kapasitesini 4 kat eksik ölçer. İlk istekteki 56 katlık gecikme ise toplam süreyi değil, özellikle ilk belirteç süresini (TTFT) yansıtır.
İşlem Hacmi Taraması (The Throughput Sweep)
64 çıktı belirteci, eşzamanlılık 1 ve 3 tekrarın medyan değerleri ("Gauge": kararlı durum decode hızı, "End-to-End": prefill dahil toplam süre):
| Girdi Belirteci | 🥈 g5g Gauge | g5g End-to-End | 🥇 g6 Gauge | g6 End-to-End |
|---|---|---|---|---|
| 41 | 12.9 tok/s | 12.43 tok/s | 48.5 tok/s | 46.23 tok/s |
| 521 | 13.0 tok/s | 11.28 tok/s | 48.4 tok/s | 42.87 tok/s |
| 2.057 | 12.9 tok/s | 8.22 tok/s | 48.3 tok/s | 34.57 tok/s |
| 3.593 | — | — | 48.3 tok/s | 27.55 tok/s |
Aynı kod ve aynı ağırlıklar ile decode aşamasında net 3.7 kat hız artışı elde edilmiştir.
Uçtan Uca Süreyi Değil, Göstergeyi Okuyun
50 katlık bağlam aralığında decode hızı g5g'de yalnızca %0.8, g6'da ise %0.4 oynamaktadır. Uçtan uca hızdaki keskin düşüş, decode başarımının azalmasından değil, dolgulanmış havuzda prefill süresinin doğrusal artmasından kaynaklanır. Geliştiricilerin bu iki kavramı ayırması gerekir; çünkü her iki donanımda da decode hızını sınırlayan faktör KV önbelleği değil, ağırlıkların getirdiği işlem yüküdür.
Orijinal kaynağa buradan ulaşabilirsiniz.
Bu konuyu derinlemesine öğrenmek isterseniz: Ölçeklendirme ve Optimizasyon modülüne göz atın.
Bu konuyu daha derinlemesine öğrenmek ister misin?
Edumints'teki ücretsiz kursları incele ve bugün başla.
Kurslara Göz At →