Kuantizasyon Araç Çağırma Yeteneğini Bozar mı? 4 GB Laptop GPU'sunda Yapılan Ölçümler
İçindekiler
Lokal büyük dil modelleri (LLM) dünyasında "Q4 kuantizasyon araç çağırma (tool-calling) için güvenli mi?" sorusu sürekli tartışılır. Ancak verilen cevaplar genellikle kulaktan dolma bilgilere dayanır. Bu çalışmada, iddiaları netleştirmek adına bulut GPU'ları yerine 4 GB VRAM'e sahip RTX 3050 Laptop GPU'sunda çalışan yerel bir test ortamı kuruldu. BFCL v4 benchmark'ı (3 seed, greedy decoding) kullanılarak 0.6B ile 1.7B arasındaki küçük modeller test edildi. Ölçümlerde şema doğruluğu (SVR), argüman doğruluğu (AC) ve fonksiyon çağırma güvenilirliği (FCR) temel alındı.
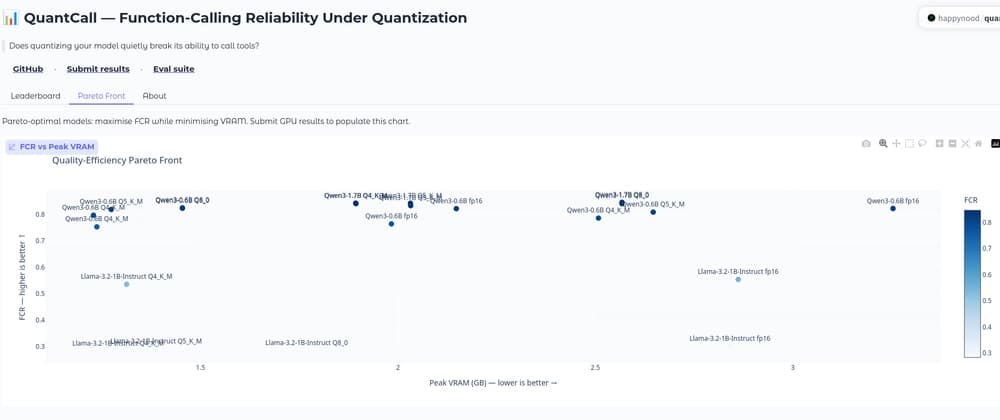
Ana Sonuç: Model Ailesi Model Boyutundan Daha Belirleyicidir
Yapılan kapsamlı testler sonucunda öne çıkan en çarpıcı bulgular şunlardır:
- Qwen3-0.6B, en agresif kuantizasyon seviyesi olan Q4_K_M değerine kadar şema geçerliliğini başarıyla korudu. Sadece en düşük sıkıştırmada argüman doğruluğunda hafif kayıplar yaşandı.
- Llama-3.2-1B, en kararlı olduğu varsayılan Q8_0 seviyesinde bile şema doğruluğu konusunda başarısız oldu. Modelin argüman doğruluğu genel olarak düşük kaldı; örneğin sayısal değerleri doğrudan sayı yerine JSON doğrulayıcıların reddettiği tırnak içinde string formatında ("10") döndürme eğilimi gösterdi.
Öğrenme Çıkarımı: Küçük modellerle çalışırken sadece parametre boyutuna bakarak performans tahmini yapmak yanlıştır. Model ailesinin kuantizasyon hassasiyeti ve çıktı formatlama kararlılığı çok daha önemlidir.
Zorlu Görevler Aradaki Farkı Büyütüyor
Basit tekil araç çağırma görevleri (T1 ve T6) yerine paralel araç çağırma (T2) ve gerçekçi katalog yapıları (T3) test edildiğinde performans kaybı çok daha belirgin hale geldi:
- Llama-3.2-1B modelinin Q4_K_M seviyesindeki şema doğruluk kaybı, zorlu görevlerde basit görevlere kıyasla yaklaşık 5 kat daha fazla oldu.
- Qwen3-0.6B ise zor görevlerde bile fp16 seviyesindeki kararlı performansını sürdürmeyi başardı.
Öğrenme Çıkarımı: Geliştiriciler olarak modellerimizi test ederken sadece en basit mutlu yolu (happy path) değil, gerçek dünya senaryolarını yansıtan karmaşık paralel çağrıları test etmeliyiz.
Negatif Olarak Raporlanan İki Önemli Sonuç
Araştırmada teoride faydalı görünen fakat pratikte işe yaramayan iki durum tespit edildi:
- GBNF Gramer Sınırlandırması: Şemayı zorunlu kılan gramer kısıtlamaları Qwen3 modelinin doğruluğunu artırmazken, istek başına işlem süresini %6 ile %86 arasında geciktirdi.
- Sunucu Backend Farkı: llama.cpp (GGUF) ile Hugging Face Transformers kütüphaneleri arasında aynı hassasiyet seviyesinde istatistiksel bir fark gözlemlenmedi. Yani performans kaybı sunucudan değil, kuantizasyonun kendisinden kaynaklanmaktadır.
Öğrenme Çıkarımı: Üretim ortamında çıktı doğruluğunu garanti etmek için eklenen kısıtlayıcı katmanların getirdiği ek gecikme maliyeti her zaman ölçülmeli ve optimize edilmelidir.
Çalışmayı Yeniden Üretmek
QuantCall projesi açık kaynaklıdır ve sonuçları doğrulamak için kendi yerel cihazınızda şu adımları izleyebilirsiniz:
pip install uvgit clone https://github.com/Happynood/quant-toolcall-benchcd quant-toolcall-bench && uv syncquantcall run --config configs/smoke.yaml
Sonuç olarak, Q4 veya Q6 kuantizasyonu seçerken ezbere kararlar yerine model ailesini ve hedef görevlerin zorluk derecesini analiz etmeniz gerekir.
Orijinal makaleye buradan ulaşabilirsiniz.
Bu konuyu daha derinlemesine öğrenmek ister misin?
Edumints'teki ücretsiz kursları incele ve bugün başla.
Kurslara Göz At →