Kendi Çıkarım (Inference) Motorumuzu Geliştirdik ve Dört Model ile Üç Farklı GPU'da vLLM ve SGLang ile Karşılaştırdık
Kaynak: dev.to
İçindekiler 5 başlık
357 saniye. Sekiz adet B200 GPU ve 32 eşzamanlı iş akışı altında GLM-5.3 modelini vLLM üzerinde sürekli yük altında çalıştırdığımızda, ortanca (median) bir isteğin ilk token'ı (TTFT) almak için beklediği süre tam olarak buydu. Aynı model ve aynı donanımda bizim geliştirdiğimiz çıkarım motoru ise bu süreyi 3,24 saniyeye indirdi.
Bu motor bir vLLM çatalı (fork) veya kuantize edilmiş bir model değil. Rob ve ekibin uzun süredir üzerinde çalıştığı, modeli tam hassasiyetle (full precision) çalıştırıp tam yanıt üreten sıfırdan yazılmış özel bir çıkarım motoru.
Karşılaştırma Tablosu (Scorecard)#
| Model | Donanım | Rakip | Sonuç |
|---|---|---|---|
| GLM-5.3 (BF16) | 8× B200 | vLLM 0.32 | 4,94× sürekli çıktı üretim hızı (throughput) |
| Qwen3.6-35B-A3B (BF16) | 1× RTX PRO 6000 Blackwell | vLLM 0.33 | 1,95×'e kadar throughput, 5,75×'e kadar daha hızlı ortanca TTFT |
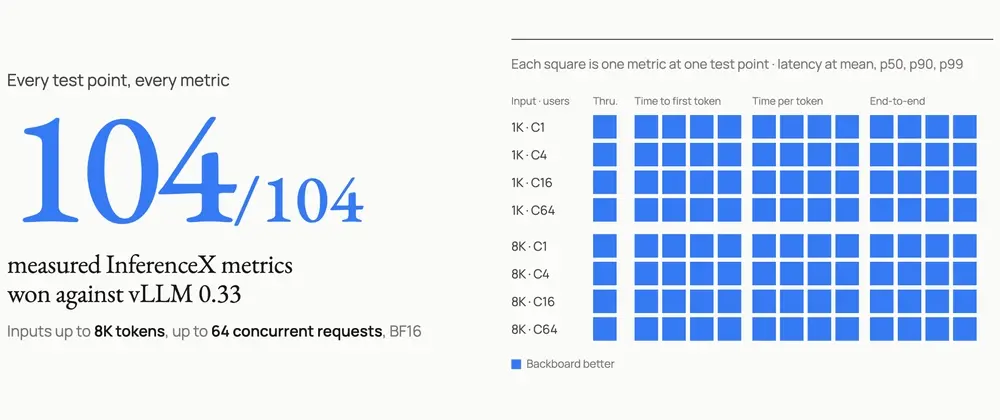
| Qwen3.8-27B (BF16) | 1× RTX PRO 6000 Blackwell | vLLM 0.33 ve SGLang | vLLM'e karşı 104/104, SGLang'e karşı 102/104 metrikte üstünlük |
| Qwen3.8-Flash-Next (BF16) | 8× H100 | SGLang (FP8) | AgentX üzerinde 12,8×'e kadar p90 etkileşim hızı |
8× B200 Üzerinde GLM-5.3#
30 dakikalık zaman diliminde 32 aktif iş akışı hedeflendi. Her iki motora da ilk 116 iş akışı aynı şekilde verildi:
- Çıktı Üretim Hızı (Output throughput): 370,0 vs 74,9 tok/sn (4,94×)
- Kabul Edilen İş Akışı: 462 vs 116
- Ortanca TTFT: 3,24 sn vs 357,5 sn
- İstek Başına Üretim: 15,8 vs 7,7 tok/sn (2,05×)
İşleri daha hızlı temizlediğimiz için yeni iş almaya devam ettik; vLLM ilk partiyi bile aşamadı. Aynı anda 96 iş akışının bırakıldığı ani yük (burst) testinde ise 2,61× throughput ve 10× daha hızlı ortanca TTFT elde ettik. Biz 96 işin 95'ini tamamlarken vLLM 82'de kaldı.
Tek GPU'da Qwen3.6-35B#
Google Cloud üzerinde tek bir RTX PRO 6000 Blackwell, BF16 hassasiyeti, 3 MTP taslak (draft) token'ı ve 32K bağlam (context) ile test edildi. Adil bir karşılaştırma için vLLM %95 GPU bellek kullanımına göre optimize edildi:
| Eşzamanlılık (Concurrency) | 8 | 16 | 32 | 64 | 128 | 256 |
|---|---|---|---|---|---|---|
| vLLM'e Göre Throughput | 1,63× | 1,57× | 1,62× | 1,65× | 1,87× | 1,95× |
8'den 256 eşzamanlı isteğe kadar her seviyede 1,5× üzeri performans sağlandı. Ortanca TTFT düzenli trafikte 5,75×, ani yükte 8,56× daha hızlıydı. İstemler; sohbet, uzun belge soru-cevap, matematik, kod ve araç kullanımından (Dolly, LongBench, MATH, HumanEval, Glaive) oluşuyordu.
Qwen3.8-27B vs vLLM ve SGLang#
Daha küçük modellerde motorlar birbirine yaklaşır; bu yüzden SGLang'i de dahil ettik. 8 iş yükü noktası × 13 metrik üzerinden motor başına 104 karşılaştırma yapıldı:
- vLLM 0.33 karşısında: 104'te 104 üstünlük
- SGLang karşısında: 104'te 102 üstünlük
Throughput vLLM'e göre %44'e, SGLang'e göre %26'ya kadar daha yüksekti. 1K girdi ve 64 eşzamanlı istekte ortanca TTFT bizim motorumuzda 299 ms iken vLLM'de 13,3 saniye sürdü. Burada özel bir 4-bit taslak başlığı (draft head) kullanıyoruz ancak BF16 ana model her taslak token'ı doğruladığı için tam model çıktısı alıyorsunuz.
Ajan (Agent) Testi ve Mühendislik Çıkarımları#
SemiAnalysis AgentX; uzun çok turlu oturumları, paylaşılan bağlamı ve alt ajanları simüle eder. İstek başına ortalama girdi 87K ile 106K token arasındaydı — gerçek müşteri trafiği tam olarak böyledir. 8× H100 üzerinde Qwen3.8-Flash-Next sonuçları:
- p90 etkileşim (1 oturum): Kullanıcı başına 209,0 vs 16,3 tok/sn (12,8×)
- Çoklu oturum: 12 oturumda 7,0×, 16 oturumda 5,0×
- p90 TTFT (1 oturum): 0,78 sn vs 10,6 sn
Üstelik SGLang referansı FP8 (kestirme yol) kullanırken, biz BF16 (tam hassasiyet) çalıştırarak kazandık.
Pratik Çıkarımlar (Ölçeklendirme ve Optimizasyon):
- Gerçek Yüklerle Test Edin: Basit sohbet kıyaslamaları, 100K+ bağlam kullanan kodlama ajanlarının üretim yükünü yansıtmaz.
- Spekülatif Kod Çözme (Speculative Decoding): 4-bit taslak başlığı ile BF16 doğrulamasını birleştirmek, doğruluktan ödün vermeden gecikmeyi (latency) dramatik biçimde düşürür.
- Kuyruk Yönetimi: Yüksek TTFT tüm boru hattını tıkar; hızlı iş temizleme kapasitesi doğrudan sistemin kabul edebileceği toplam iş hacmini belirler.
Kaynak ve atıf
Bu yazı, dev.to üzerinde yayımlanan içerikten yararlanılarak Edumints tarafından yapay zekâ desteğiyle Türkçe hazırlandı. Ayrıntılar ve yazarların kendi anlatımı için orijinaline bakabilirsin:
- dev.to/jon_at_backboardio/we-built-our-own-inference-engine-and-put-it-up-against-vllm-and-sglang-on-four-models-and-three-12b