GKE Üzerinde Bölünmeye Dayanıklı Yapay Zekâ İş Yükleri Geliştirmek
İçindekiler
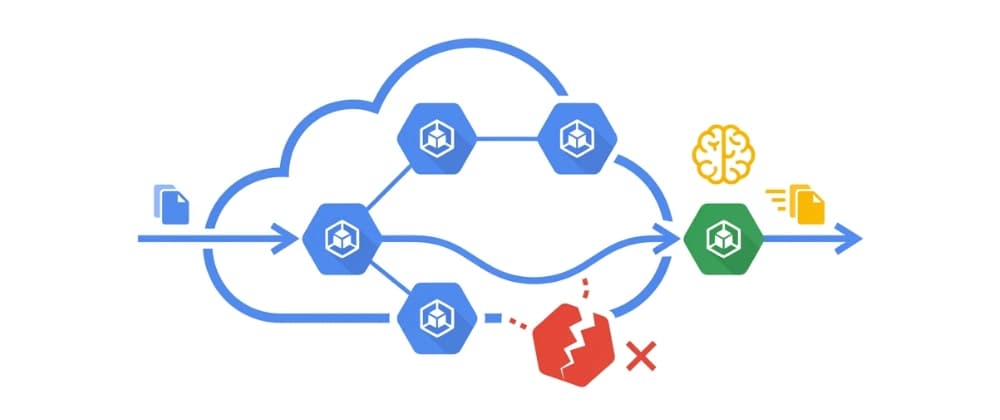
Maliyetleri %90'a varan oranda düşürmek için GKE (Google Kubernetes Engine) üzerinde Spot VM node'ları kullanmak harika bir stratejidir. Ancak geçici (ephemeral) altyapılar kullanıldığında, sunucuların her an geri alınabileceği (eviction) gerçeğini kabul etmelisiniz. Kesintisiz çalışan yapay zekâ iş yükleri oluşturmak için sisteminizin hata odaklı tasarlanması gerekir.
İşte GKE üzerinde kesintilere dayanıklı yapay zekâ iş yükleri geliştirmenin 4 temel adımı ve yazılım geliştiriciler için pratik çıkarımları:
1. Uyanık Olun: Uyarı Sinyallerini Yakalayın
Google Cloud bir Spot VM'i geri almadan önce ACPI sinyali gönderir ve Kubernetes bunu container'lara SIGTERM olarak iletir. Bu aşamada SIGKILL sinyali gelene kadar yaklaşık 15 saniyelik bir tolerans süreniz vardır.
- Pratik Çıkarım: Python'daki
signalkütüphanesini kullanarak SIGTERM sinyalini yakalayın. Sinyali aldığınızda yeni veri kabul etmeyi durdurun, mevcut döngüyü tamamlayın ve durum bilgilerini diske kaydedip exit(0) ile güvenli şekilde çıkış yapın.
2. Checkpoint'leri Harici Depolamada Tutun
Konteyner sonlandırıldığında yerel diskteki tüm veriler kaybolur. Bu yüzden model ağırlıkları ve optimizer durumları gibi ilerlemeleri düzenli olarak Google Cloud Storage (GCS) gibi harici bir alana kaydetmelisiniz.
- Pratik Çıkarım: Checkpoint sıklığını iyi ayarlayın; kaydetme maliyeti ile kaybolabilecek iş miktarını dengeleyin. Konteyner ayağa kalkarken ilk iş olarak GCS'te kayıtlı bir checkpoint olup olmadığını kontrol edin ve eğitim döngüsünü oradan başlatın.
3. Idempotency (Eşgüçlülük) İlkesine Göre Tasarlayın
Bir işlemin birden fazla kez çalıştırılmasıyla bir kez çalıştırılması aynı sonucu vermelidir. Yarıda kesilen bir pod, veritabanına veri yazdıktan sonra çökerse, yeniden başladığında veriyi mükerrer işleyebilir.
- Pratik Çıkarım: Veritabanı işlemlerinde benzersiz kimlikler (ID) kullanarak UPSERT (güncelle veya ekle) işlemlerini tercih edin. Ağır GPU döngülerine girmeden önce ilgili kaydın zaten işlenip işlenmediğini mutlaka kontrol edin.
4. Toplu İşlemler İçin İş Kuyruklarını Ayrıştırın
Binlerce dosyayı işleyen monolitik script'ler yazmak yerine iş yükünü parçalara ayırın.
- Pratik Çıkarım: Verilerinizi Pub/Sub gibi bir mesaj kuyruğuna aktarın. Spot VM pod'ları kuyruktan tek tek iş çeksin. Bir pod kesintiye uğrarsa, işlem onaylanmadığı (ACK edilmediği) için mesaj kuyruğa geri döner ve başka bir çalışan pod tarafından otomatik olarak tamamlanır.
Sonuç ve Geliştirici Çıkarımları
Spot VM kullanmak sadece altyapısal bir tercih değil, mimari bir tasarım kararıdır. İş yüklerimizi sinyal yönetimi, checkpoint'ler ve kuyruk sistemleri ile dayanıklı hale getirerek, bulut maliyetlerini optimize ederken güvenilirlikten ödün vermemeyi öğrenmeliyiz.
Bu konuyu daha derinlemesine öğrenmek ister misin?
Edumints'teki ücretsiz kursları incele ve bugün başla.
Kurslara Göz At →