Eşzamanlı Çıkarımda Ollama ve vLLM Karşılaştırması: Doğru Sunucu Nasıl Seçilir?
İçindekiler
Ollama ile vLLM arasında seçim yapmak yalnızca "Hangi çıkarım motoru daha hızlı?" sorusundan ibaret değildir; doğru yanıt tamamen uygulamanızın iş yüküne bağlıdır. Tek kullanıcılı bir geliştirici arayüzü ile onlarca eşzamanlı isteği karşılayan çok kullanıcılı bir üretim API'sinin gereksinimleri bambaşkadır. Bazı senaryolarda model yönetim kolaylığı kritik öneme sahipken, diğerlerinde belirleyici unsurlar şunlardır:
- Sürekli paketleme (Continuous batching)
- Kuyruk davranışı (Queue behavior)
- KV-önbellek (KV-cache) kullanımı
- İlk token süresi (TTFT)
- p99 gecikme süreleri
- GPU doygunluğu (GPU saturation)
- Aşırı yük yönetimi (Overload handling)
Bu rehberin sonunda şunları öğrenmiş olacaksınız:
- vLLM'in paketleme mimarisinin ne zaman ölçülebilir bir avantaj sağladığını
- Ollama'nın daha küçük iş yükleri için neden halen daha iyi bir seçenek olduğunu
- Gerçekçi bir eşzamanlılık testi (concurrency sweep) kurgulama yöntemini
- Hangi gecikme ve verim (throughput) metriklerinin gerçekten önemli olduğunu
- Kuyruk birikmesini ve donanım doygunluğunu tespit etme yollarını
- Hizmet seviyesi hedeflerinize (SLO) sadık kalan sunucuyu nasıl seçeceğinizi
Kısa Cevap
vLLM'in Ollama'dan aniden üstün geldiği evrensel tek bir eşzamanlılık sınırı yoktur. vLLM, GPU kaynakları elverirken zamanlayıcısının verimli paketler oluşturabileceği kadar istek aktif veya kuyrukta olduğunda avantaj kazanır:
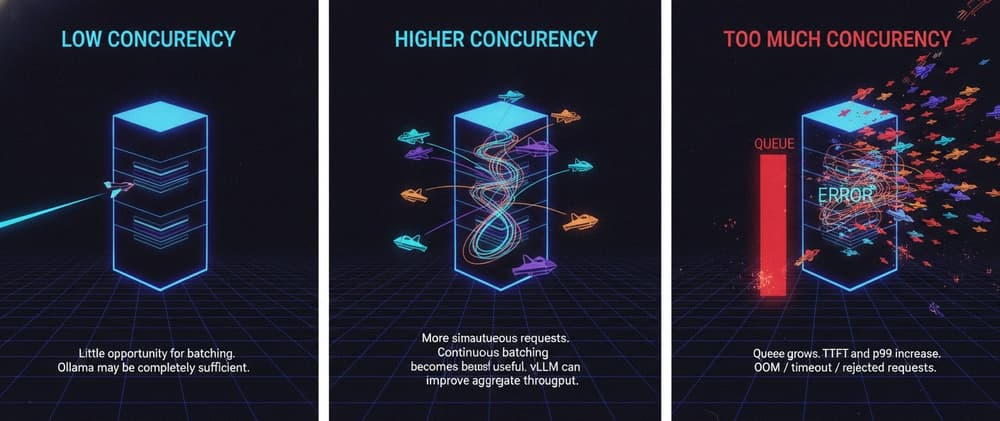
- Düşük eşzamanlılık: Paketleme fırsatı azdır; Ollama geliştirme ve test süreçleri için fazlasıyla yeterlidir.
- Yüksek eşzamanlılık: Eşzamanlı istekler artar; sürekli paketleme devreye girer ve vLLM toplam verimi yükseltir.
- Aşırı eşzamanlılık: Kuyruk büyür; TTFT ve p99 fırlar, bellek aşımı (OOM) veya zaman aşımları başlar.
Asıl soru en yüksek saniye başına token (tokens/s) değerine ulaşmak değil; gecikme, hata oranları, bellek ve operasyonel karmaşıklığı sınırlar içinde tutarak hedeflenen verimi elde etmektir.
Çıkarım Motoruyla Değil, İş Yüküyle Başlayın
Sunucuları kıyaslamadan önce sisteminizin gerçekte neyi yöneteceğini netleştirin:
Kişisel Sohbet (Personal Chat)
- Tek bir aktif kullanıcı
- Düşük eşzamanlılık
- Ara sıra gerçekleşen model yükleme
- Başlangıç gecikmesine karşı görece tolerans
- Sunucu tarafında büyük bir istek kuyruğunun bulunmaması
Küçük Dahili API (Small Internal API)
- Birkaç eşzamanlı kullanıcı
- Kısa süreli istek patlamaları
- Değişken bağlam (context) uzunlukları
- Ara sıra yaşanan eşzamanlılık sıçramaları
- Makul gecikme gereksinimleri
Yüksek Eşzamanlı Çıkarım Servisi (High-Concurrency Inference Service)
- Çok sayıda eşzamanlı istek
- Kesintisiz devam eden kuyruklar
- Katı TTFT hedefleri
- p95/p99 gecikme sınırları
- Yüksek GPU kullanım hedefleri
- Öngörülebilir yönetilmesi gereken aşırı yük durumları
Kıyaslama (Benchmark) Öncesinde İş Yükünü Kaydedin
Yazılım mimarinizi test ederken en azından şu değişkenleri kayıt altına alın:
- Girdi token'ları: Prefill aşamasının hesaplama maliyetini belirler.
- Çıktı token'ları: İsteğin üretim kaynaklarını ne kadar süre meşgul edeceğini gösterir.
- Ortalama eşzamanlılık: Normal çalışma yükünü temsil eder.
- Zirve eşzamanlılık: Sistemin doygunluk ve darboğaz davranışını ortaya çıkarır.
- Akış (Streaming) oranı: Kullanıcı tarafından algılanan gecikmeyi doğrudan etkiler.
- Bağlam uzunluğu: KV-önbellek bellek tüketimini doğrudan belirler.
[Orijinal kaynağa buradan ulaşabilirsiniz.](https://dev.to/aeza__net/ollama-vs-vllm-for-concurrent-inference-how-to-choose-the-right-server-3o5p)
Bu konuyu daha derinlemesine öğrenmek ister misin?
Edumints'teki ücretsiz kursları incele ve bugün başla.
Kurslara Göz At →