Dikkat Mekanizmasından 3-Bit Önbelleklere: LLM'ler Daha Az Hatırlamayı Nasıl Öğrendi? (MHA, GQA, MLA, MoE ve Kuantizasyon Açıklaması)
Kaynak: dev.to
İçindekiler 6 başlık
2017 yılında sekiz araştırmacı, bilgisayar bilimleri tarihinin en iddialı başlığına sahip makalesini yayımladı: Attention Is All You Need (İhtiyacınız Olan Tek Şey Dikkat). Haklıydılar; ancak endüstrinin geri kalanının çözmesi dokuz yıl sürecek küçük bir dipnot vardı: İhtiyacınız olan tek şey dikkat mekanizması, konuşma başına 16 GB bellek, bir depo dolusu GPU ve bir enerji santralidir.
Bu yazı, bir araştırma oyuncağını her gün kullandığımız sohbet robotlarına dönüştüren akıllı mühendislik çözümlerinin hikayesidir. Yazılım geliştiriciler için bu evrimi anlamak, modern yapay zeka sistemlerinde bellek darboğazlarını ve maliyet optimizasyonunu yönetmenin anahtarıdır.
İçindekiler#
- Beş dakikada dikkat (Attention) mekanizması
- KV önbelleği (KV cache): Restoranı yutan garson not defteri
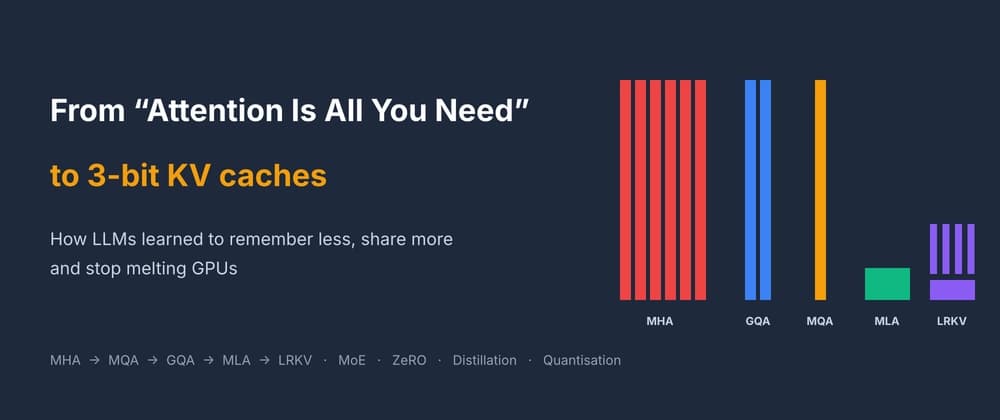
- Dikkat mekanizmasının evrimi: MHA → MQA → GQA → MLA → LRKV
- KV önbelleğini dizginlemek: Üç temel yöntem ailesi
- Uzmanların Karışımı (Mixture of Experts - MoE): Vergilerinizi dişçiye sormayı bırakın
- Eğitimi ölçeklendirmek: Paralellik, ZeRO ve FSDP
- Damıtma (Distillation): Sınıf birincisinin notlarını kopyalayan küçük model
- Kuantizasyon (Quantisation): FP8, FP4 ve TurboQuant
- Tüm bunlar GPT tarzı modelleri nasıl daha iyi hale getirdi?
- Zaman çizelgesi
1. Beş Dakikada Dikkat (Attention) Mekanizması#
Kokteyl Partisi#
Gürültülü bir partidesiniz. Aynı anda yirmi sohbet dönüyor ama odanın diğer ucunda biri adınızı söylediğinde beyniniz anında oraya odaklanıyor. Herkesi eşit dinlemediniz; dikkatinizin çoğunu önemli olan birkaç sese verdiniz.
Bir dil modeli bir cümleyi okuduğunda da her kelime diğer her kelimeye bakar ve hangisinin kendisi için ne kadar önemli olduğuna karar verir. "Kedi paspasın üzerine oturdu çünkü o yorgundu" cümlesinde "o" kelimesinin kediye işaret ettiğini model, dikkatinin çoğunu "kedi" kelimesine vererek çözer.
Query, Key, Value: Bir Arama Motoru Olarak Dikkat#
Bir kelime kimin önemli olduğuna nasıl karar verir? Her kelime üç küçük vektör (sayı listesi) taşır:
- Query (Sorgu): "Aradığım şey bu"
- Key (Anahtar): "Ben buyum"
- Value (Değer): "Beni seçersen sana söyleyeceğim şey bu"
Bunu bir kütüphane gibi düşünün. Query aklınızdaki sorudur. Her kitabın sırtındaki etiket Key, içindeki bilgi ise Value'dur. Sorunuzu her etiketle karşılaştırır ve en çok eşleşen kitapları okursunuz. Geliştiriciler için kritik çıkarım şudur: Key ve Value vektörleri, GPU belleğinizin terlemesinin asıl nedenidir.
Çok Başlı Dikkat (Multi-Head Attention - MHA): Uzmanlar Paneli#
Tek bir dikkat turu yalnızca tek bir ilişki türünü yakalar. Bu yüzden Transformer mimarisi, paralel olarak birden fazla baş (head) çalıştırır. Biri dilbilgisini, diğeri zamirlerin kime işaret ettiğini, bir diğeri ise tırnak içindeki ifadeleri takip eder. Her başın kendi sorgu, anahtar ve değerleri vardır. Bu yapıya Multi-Head Attention (MHA) denir; tıpkı bir mülakat panelinde her görüşmecinin farklı bir yetkinliği ölçmesi gibidir.
Tek Resimde Transformer#
Dikkat mekanizmasını küçük bir "düşünme" ağıyla (ileri beslemeli katman) üst üste koyup düzinelerce kez tekrarladığınızda Transformer elde edersiniz. GPT tarzı modeller tek bir iş yapar: bir sonraki token'ı tahmin etmek. Ardından bu token'ı metne ekler ve tekrar tahmin yürütür. Üretim ortamında LLM geliştiren mühendisler için bu döngü, her yeni kelimede önceki hesaplamaları bellekte tutma zorunluluğunu (ve optimizasyon ihtiyacını) doğurur.
Kaynak ve atıf
Bu yazı, dev.to üzerinde yayımlanan içerikten yararlanılarak Edumints tarafından yapay zekâ desteğiyle Türkçe hazırlandı. Ayrıntılar ve yazarların kendi anlatımı için orijinaline bakabilirsin:
- dev.to/amananandrai/from-attention-to-3-bit-caches-how-llms-learned-to-remember-less-mha-gqa-mla-moe-quantisation-3obj