Bulut T4 GPU'nuzun Kağıt Üzerindeki Hızda Çalıştığını Varsaymayın: Kart Isındıkça Gemma 4 Decode Hızı %7 Düşüyor
Kaynak: dev.to
İçindekiler 5 başlık
Bu makale, bir Google Cloud sanal makinesindeki (VM) NVIDIA Tesla T4 GPU üzerinde vLLM ile Gemma 4 E2B modeli sunulurken, kart sıcaklığının LLM decode (token üretme) hızını nasıl değiştirdiğini adım adım ölçmektedir. Tüm kayıtlar, betikler ve veriler açık kaynak olarak paylaşılmıştır (https://github.com/xbill9/t4-thermal-drift).
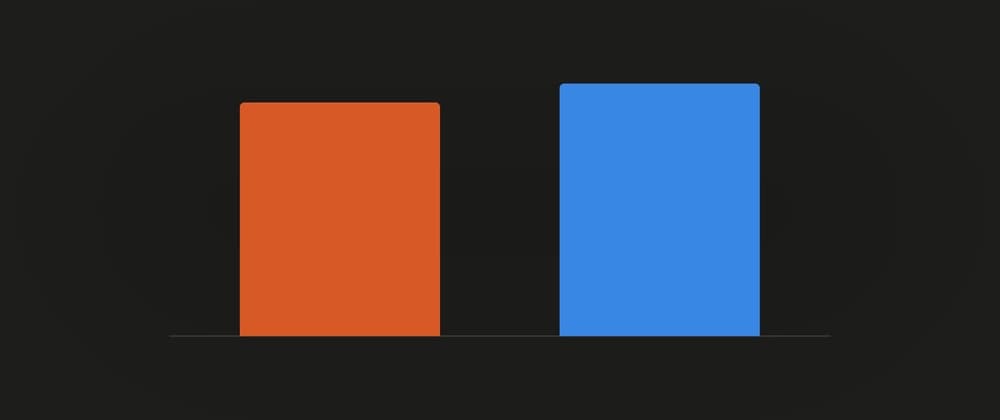
Aynı VM üzerindeki aynı T4, aynı modeli ve aynı istemi (prompt) işlerken 45 °C sıcaklıkta saniyede 115,3 token üretirken, sabitlendiği 77 °C sıcaklıkta saniyede 106,8 token üretmektedir. Yani yük devam ettiği sürece %7,4 daha yavaş çalışır. Kart tüm süreç boyunca 70 W güç sınırında çalışmaktadır. Daha sıcak bir çip aynı saat hızında (clock speed) daha fazla güç çeker; bu nedenle güç sınırı saat hızını yaklaşık 1.457 MHz'den 1.267 MHz'e düşürür. Üstelik bu süreçte termal kısıtlama (thermal throttle) bayrağı hiç tetiklenmez.
Bu Proje Ne Yapmaya Çalışıyor?#
Kiralanan bir GPU ismine ve saatlik ücretine göre satılır. T4 her yerde T4'tür ve teknik özellik sayfasında tek bir değer yazar: 8,1 TFLOPS FP32, 65 TFLOPS FP16. Üzerinde yapılan kıyaslama (benchmark) testleri genellikle bir-iki dakika çalıştırılır ve kartın hızı olarak raporlanır.
Bu proje, kart ısındığında bu değerin korunup korunmadığını sorguluyor. Kart decode işlemi yaparken her 100 ms'de bir sıcaklık, saat hızı, güç ve kısıtlama durumunu kaydederek her isteği tokenların üretildiği andaki donanım durumuyla eşleştiriyor. Elde edilen yanıt, yazılım geliştiricilerin ve mühendislerin önemsemesi gereken üç kritik noktayı şekillendirir:
- Bir T4'ün sürekli yük altında gerçekte hangi hızı sunduğu,
- Kısa süreli bir benchmark testinin performansı ne kadar abarttığı,
- Arka arkaya çalıştırılan bir A/B testinin adil olup olmadığı (ilk test soğuk kartta, ikinci test sıcak kartta çalışırsa sonuçlar yanıltıcı olacaktır).
Bu Noktada Sahip Olmanız Gerekenler#
- Bir adet NVIDIA T4 GPU içeren ve saat hızını kilitlemek (
nvidia-smi -lgc) için root erişimine sahip bir Google Cloud VM. - Kart üzerinde modeli sunan vLLM. Bu testte vLLM 0.29.0 ile 4-bit ağırlıklara ve fp16 formatına sahip
xbill9/gemma-4-E2B-it-qat-q4_0-w4a16-ct-text-emb4(Gemma 4 E2B) modeli kullanılmıştır. - Proje deposunun klonu:
git clone https://github.com/xbill9/t4-thermal-drift
Donanım Özellikleri#
Test ortamındaki donanım ve sunucu yapılandırması şu şekildedir:
- Kart ve Sürücü: Tesla T4, Sürücü 615.71.09, 15360 MiB Bellek, 70.00 W Güç Sınırı, Persistence Mode: Etkin
- Maksimum Saat Hızları: Graphics: 1590 MHz, SM: 1590 MHz
- Güç Sınırları: Mevcut, Varsayılan ve Maksimum Güç Sınırı: 70.00 W
- VM:
n1-standard-2,us-west2-b - GPU Yapısı: Tesla T4, pasif soğutma, 70 W sınır, 1.590 MHz maksimum saat hızı
- Sunucu: vLLM 0.29.0, aynı anda tek istek, greedy decoding, 256 çıktı tokenı
T4 üzerinde fiziksel bir fan yoktur; bulut sağlayıcısının kontrol ettiği ana sunucu hava akışına güvenir. Google, kartı izin verilen en yüksek güç sınırında (70 W) çalıştırmaktadır. Pratik Çıkarım: Üretim ortamında kapasite planlaması ve Ölçeklendirme ve Optimizasyon yaparken donanımın fiziksel sınırlarını göz ardı etmek, beklenmeyen gecikme (latency) artışlarına yol açar.
Adım 1 — Kartı Her 100 ms'de Bir Kayıt Altına Alın#
thermal.py betiği, her test boyunca arka planda nvidia-smi komutunu çalıştırarak her 100 ms'de bir şu sekiz alanı kaydeder:
timestamp,temperature.gpu,clocks.sm,clocks.mem,power.draw,clocks_event_reasons.active,utilization.gpu,pstate
Her istek, akış (stream) halinde gelen her tokenın gerçekleşme süresini (wall time) kaydeder. analyze.py ise bir isteğin ilk ve son tokenı arasına düşen örnekleri alır; böylece her decode hızı, üretildiği andaki sıcaklık, saat hızı ve güç tüketimiyle eşleştirilir.
Buradaki clocks_event_reasons.active alanı, saat hızının neden maksimumun altında olduğunu açıklar. Önemli olan iki değer vardır: 0x4 (yazılımsal güç sınırı / power cap) ve 0x20 / 0x40 (yazılımsal ve donanımsal termal yavaşlamalar). Pratik Çıkarım: LLM servislerinde sadece uygulama katmanı metriklerini değil, donanım telemetrisini de Üretim Observability Pipeline süreçlerine dahil etmek, görünmeyen performans düşüşlerini yakalamak için şarttır.
Adım 2 — Soğuk Karttan Başlayarak Isı Yükleme (Heat Soak) Testi Çalıştırın#
Isı yükleme testi, kart 50 °C'nin altına düşene kadar bekler, sunucuyu başlatır ve arka arkaya aynı istemi (greedy, her biri 256 token) gönderir:
python3 thermal.py soak runs/2026-10-15-first-t4/soak-unlocked-5min-1 --minutes 5
Bu yaklaşım, soğuk başlangıç ile kararlı sıcaklık durumu arasındaki performans farkını net bir şekilde ortaya koyar. Model veya Prompt Versioning ve A/B Testi süreçlerinde donanım sıcaklığını sabit tutmak veya hesaba katmak, mühendislik testlerinin güvenilirliğini doğrudan artıracaktır.
Kaynak ve atıf
Bu yazı, dev.to üzerinde yayımlanan içerikten yararlanılarak Edumints tarafından yapay zekâ desteğiyle Türkçe hazırlandı. Ayrıntılar ve yazarların kendi anlatımı için orijinaline bakabilirsin:
- dev.to/gde/dont-assume-your-cloud-t4-runs-at-spec-gemma-4-decode-falls-7-as-the-card-warms-3fd3