Bir LLM API'sini Çağırdığınızda Arka Planda Neler Olur?
İçindekiler
Bir istem gönderdiğinizde yanıt bazen anında gelir, bazen de saniyelerce beklersiniz. Suçlu internetiniz değil; arka planda okyanusları aşan ve uzaklardaki bir veri merkezine uzanan fiziksel bir yolculuk vardır. Yazılım geliştiriciler olarak bu altyapıyı anlamak, daha kararlı sistemler kurmamızı sağlar.
1. Bir API Çağrısının Yolculuğu
İsteğiniz cihazınızdan çıkıp denizaltı fiber optik kablolarıyla okyanusu aşarak veri merkezine ulaşır, GPU'da işlenir ve aynı yolla döner. Coğrafi konumunuz bu yolculuğun süresini doğrudan belirler. Geliştiriciler olarak yazdığımız kodun küresel ağ sınırlarına tabi olduğunu unutmamalıyız.
2. Veri Merkezi Aslında Nedir?
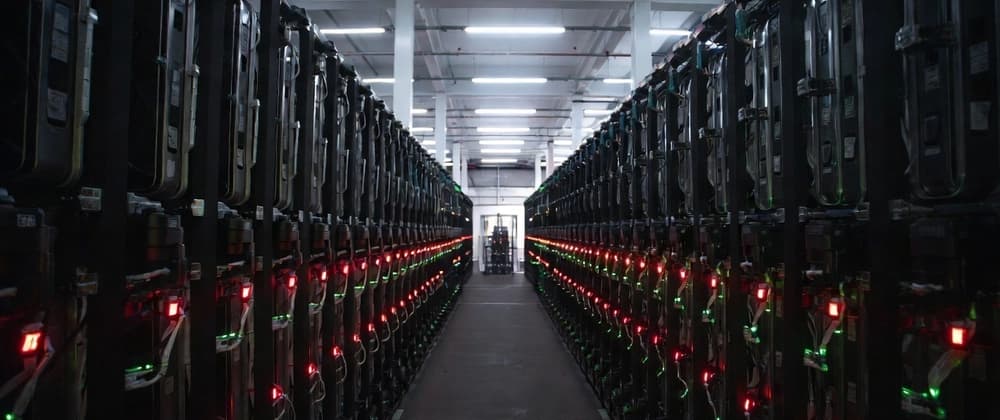
Veri merkezleri, devasa boyutlarda, binlerce ekransız sunucunun 7/24 çalıştığı binalardır. Elektrik, soğutma ve ağ bağlantısıyla hayatta kalırlar. Altyapı maliyetlerini ve donanım mimarisini kavramak, bulut projelerinde kaynakları doğru yönetebilmek için temel bir öğrenme adımıdır.
3. Gecikme (Latency): Fizik Problemi
Veri, fiber kabloda ışık hızının üçte ikisiyle hareket eder. Lagos ile Londra arası mesafe gibi fiziksel sınırlar yüzünden, isteğinize daha işlenmeden 100-200 ms gecikme eklenir. Kodumuzu optimize etmeden önce sunucu bölgelerini kullanıcılarımıza yakın seçerek bu fiziksel engeli aşabiliriz.
4. Çıkarım (Inference): GPU Gerçekte Ne Yapıyor?
Yapay zeka modeli, kelimeleri eşleştirmek yerine her bir token'ı (kelimenin 3/4'ü) sırayla tahmin etmek için milyarlarca matematiksel işlem yapar. Token mantığını bilmek, gereksiz uzunluktaki prompt'lardan kaçınarak hem bütçeyi hem de hızı kontrol altında tutmamızı sağlar.
5. GPU: Neden Bu Donanım?
CPU genel görevlerde hızlıyken, GPU binlerce çekirdeğiyle milyarlarca parametreyi aynı anda işleyebilir. İstekleriniz yoğunluktan dolayı GPU sırasında beklediğinde, bu durum gecikme ve hız limitleri olarak yansır. Donanım kısıtlamalarına göre mimari tasarlamayı öğrenmeliyiz.
6. Soğuk Başlangıçlar (Cold Starts)
Büyük modellerin ağırlıklarının GPU belleğine yüklenmesi zaman alır. Model bir süre kullanılmadığında bellekten boşaltılabilir; bu yüzden ilk istek yavaş, sonrakiler hızlı yanıt verir. Canlı uygulamalarda "keep-alive" mekanizmaları kurarak kullanıcı deneyimini koruyabiliriz.
7. Neden Özellikle Nijerya?
Nijerya'daki veri merkezleri kesintili şebeke yüzünden sürekli jeneratörlerle çalışır. Bu maliyetli altyapı açığı nedeniyle, bölgedeki geliştiriciler yurt dışındaki sunuculara bağımlıdır. Gelişmekte olan pazarlar için yazılım geliştirirken bu bölgesel gecikme farklarını hesaba katmak şarttır.
8. Geliştiriciler İçin Pratik Çıkarımlar
Uygulama geliştirirken performansı optimize etmek için şu pratik adımları uygulamalıyız:
- Yanıtları Akıtın (Streaming): Kullanıcı arayüzünde (UI) gecikmeyi hissettirmemek için yanıtı parça parça gösteren SSE veya WebSocket teknolojilerini kullanın.
- Önbellekleme (Caching) Yapın: Redis gibi çözümlerle sık tekrarlanan istemleri önbelleğe alarak API maliyetlerini düşürün.
- Doğru Modeli Seçin: Basit görevler için devasa modeller yerine daha hızlı ve ucuz küçük modelleri tercih edin.
9. Büyük Resim
Yapay zeka havada asılı değildir; fiziksel altyapıya bağlıdır. Küresel veri merkezi kapasitesindeki eşitsizlikleri bilmek, kod yazmanın ötesine geçerek donanım, enerji ve jeopolitik gerçekleri de kapsayan geniş bir mühendislik vizyonu kazanmamıza yardımcı olur.
Bu konuyu daha derinlemesine öğrenmek ister misin?
Edumints'teki ücretsiz kursları incele ve bugün başla.
Kurslara Göz At →