AI Ajanınız İçin Değerlendirme Sistemi (Evaluation Harness) Nasıl Kurulur? (Üretimde Hata Vermemesi İçin)
İçindekiler
Yapay zeka (AI) ajanınızı geliştirirken elinizle yaptığınız manuel testler yanıltıcıdır. prompt (girdi) değişikliklerinin sistemi sessizce bozmaması için otomatik bir değerlendirme sistemi kurmalısınız.
Ne İnşa Edeceksiniz: Minimal Bir AI Ajan Değerlendirme Sistemi
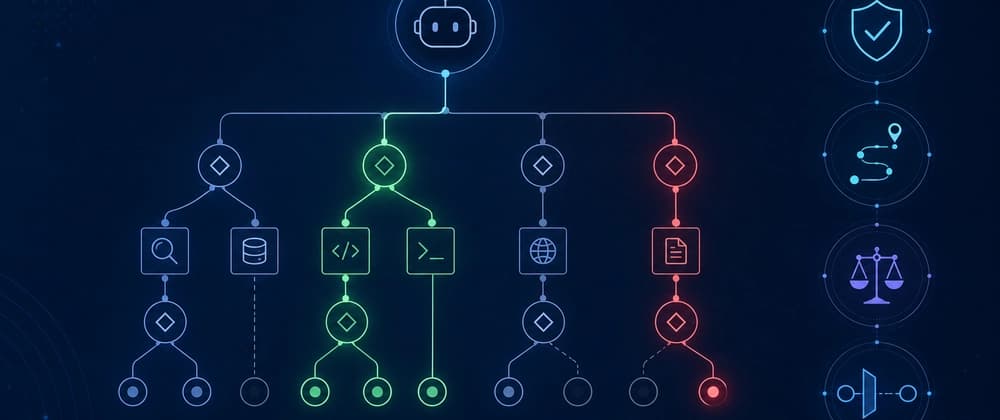
Seyahat destek ajanı üzerinden kuracağımız yapıda şu dört değerlendiriciyi (grader) oluşturacağız:
- Doğruluk (Truth): Ajan doğru araçları doğru argümanlarla çağırdı mı?
- Yol (Path): Döngüye girmeden veya gereksiz kaynak tüketmeden makul bir yol izledi mi?
- Hakem (Judge): Esnek hedefleri başarıyla gerçekleştirdi mi?
- Geçit (Gate): Yapılan değişiklik performansı düşürdü mü?
Ön Koşullar
- Python 3.10+ bilgisi ve paket kurulumu deneyimi.
pytesttest çatısı ve LLM çağrıları için API anahtarları.- Çağrılan araçları ve nihai yanıtları dönen bir ajan yapısı.
- Değerlendirme tecrübesinin olmaması ("benim makinemde çalışıyor" algısını kırmak).
Manuel Testler Neden Yanıltıcıdır?
Ajanları sadece manuel gözlemlerle test etmek üç büyük risk barındırır:
- Demo testin kendisidir: Geliştiricinin sadece bildiği "mutlu yolları" test etmesi yanıltıcı bir güven verir.
- Belirsizlik (Non-determinism): Aynı girdi, sıcaklık ayarları veya model güncellemeleri nedeniyle farklı çıktılar üretebilir.
- Sessiz gerilemeler (Silent regressions): Bir prompt güncellemesi fark edilmeden başka bir araç çağrısını bozabilir.
Bir Ajan Değerlendirmesinin Üç Seviyesi
Değerlendirme hiyerarşisini şu üç katmanda ele almalıyız:
- Uçtan Uca (End-to-End): Ajanın görevi genel olarak tamamlayıp tamamlamadığı (Hakem seviyesi).
- Yörünge (Trajectory): İzlenen adımların ve araç kullanım planının doğruluğu (Doğruluk ve Yol seviyesi).
- Bileşen (Component): Tekil araç veya bilgi geri getirme (retriever) başarısı.
Adım 1: Gerçek Hatalardan Altın Veri Seti Oluşturun
Veri seti hazırlarken şu iki temel kurala uymalıyız:
- Küçük başlayın ve gerçek hatalardan beslenin: 20-50 arası gerçek hata kaydından oluşan bir set yeterlidir.
- Geçme/kalma durumunu netleştirin: Uzmanların üzerinde kolayca mutabık kalacağı net başarı metrikleri seçin.
Adım 2: Değerlendirici 1 — Doğruluk (Truth)
Doğruluk kontrolü, aracın doğru argümanlarla çalışıp çalışmadığını ölçen deterministik ve ücretsiz bir koddur. Pratik çıkarım: Yazılım geliştiriciler için hatalı API kullanımını anında yakalayarak bütçe kaybını önler.
Adım 3: Değerlendirici 2 — Yol (Path)
Bu aşamada adım verimliliği kontrol edilir. Öğrenme çıkarımı: Sonsuz döngüleri ve mükerrer araç çağrılarını yakalayarak sistem kaynaklarını korumak, ajan mimarisinde verim optimizasyonu sağlar.
Adım 4: Değerlendirici 3 — Hakem (Judge)
Net bir metin eşleşmesi olmadığında LLM hakemliğini kullanırız. Çıkarım: Hakemin kararlarını CI/CD'ye bağlamadan önce insan etiketleriyle kalibre etmek güvenilirlik açısından şarttır.
Adım 5: Değerlendirici 4 — Geçit (Gate)
Tüm değerlendirmeleri pytest testlerine bağlayarak CI hattında koşturun. Regresyon durumunda entegrasyonu (merge) engellemek, ajan kalitesini korumada en güçlü geçittir.
Sonuç: Ajanları Hislerinizle Yayına Almayı Bırakın
Yapay zeka projelerini geleneksel test süreçleriyle birleştirmek sürdürülebilirliğin anahtarıdır. Sonraki adımlarınız şunlar olmalıdır:
- Üretim ortamındaki hatalarla veri setinizi sürekli büyütün.
- LLM hakeminizi düzenli olarak kalibre edin.
- Hata tespiti için bileşen düzeyinde testler ekleyin.
- Başarı skorlarınızı zaman içinde grafiklerle takip edin.
[Orijinal kaynağa buradan ulaşabilirsiniz.](https://dev.to/ravi3divi/how-to-build-an-evaluation-harness-for-your-ai-agent-so-it-doesnt-break-in-production-1h6p)
Bu konuyu daha derinlemesine öğrenmek ister misin?
Edumints'teki ücretsiz kursları incele ve bugün başla.
Kurslara Göz At →