8 LLM, 480 Soru, 1 Kaggle Kıyaslaması: Trafik Düşüşünü Hangi Model Açıklayabilir?
İçindekiler
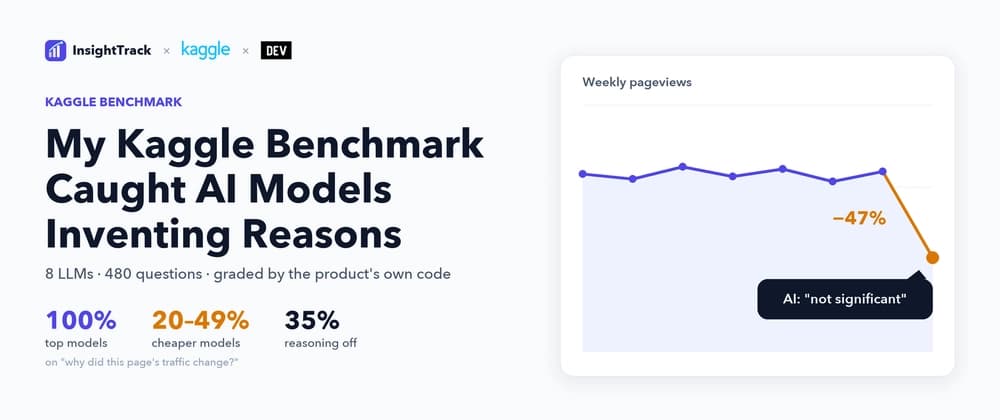
Açık kaynaklı web analitiği platformu InsightTrack, "/pricing sayfasına gelen trafik neden düştü?" gibi soruları yanıtlayan Pulse adlı bir yapay zeka analistine sahiptir. Pulse, doğru araçları seçip sayıları analiz ederek sade bir dille açıklama yapar. Bu sistemde kullanılacak modeli "sezgilerle" değil somut kanıtlarla seçmek amacıyla, Pulse'ın gerçek görevleri 480 otomatik puanlanan sorudan oluşan bir Kaggle benchmark testine dönüştürüldü.
Problem: Yapay Zeka Analistinin Özgüvenli Yanılgıları
Analitik asistanları sıradan sohbet botları değildir; ekipler onların analizlerine dayanarak sayfaları yeniden yazar veya kampanyaları durdurur. Bir modelin hata yapması iki maliyetli şekilde gerçekleşir:
- Neden uydurması: Trafik tatil veya önemsiz bir dalgalanma yüzünden değiştiğinde, modelin suçu özgüvenle SEO sıralamasına atması (bozuk olmayan şeyleri onarmakla zaman kaybedersiniz).
- Gerçek bir problemi kaçırması: Trafik yarı yarıya düştüğünde modelin "önemli bir şey olmadı" demesi.
Her iki durum da "bilmiyorum" demekten çok daha zararlıdır. Üretim seviyesinde bir analist, genel liderlik tablolarında ölçülmeyen şu üç alışkanlığa sahip olmalıdır:
- Ölçülülük (Restraint): Veride karşılığı yoksa durumun sadece bir "gürültü" olduğunu söyleyebilmek.
- Sayısal kurallara kesin uyum: Eşik değerleri harfiyen uygulamak (örneğin 6 ziyaretçideki %15'lik değişim bir trend değildir).
- Gerçek araç çıktılarını okuma: Ders kitabı örnekleri yerine ürünün ürettiği ham alanları, yuvarlamaları ve biçimleri hatasız yorumlamak.
Genel Kıyaslamalar Neden Yetersiz Kalır?
Genel benchmark'lar kod yazma veya fonksiyon çağırma becerisini ölçebilir; ancak ürün seviyesinde model seçimi şu üç kritik soruya yanıt veremez:
- Özel görevdeki doğruluk: Kendi araç setiniz, özel veri formatlarınız ve veritabanı lehçenizdeki (örneğin PostgreSQL değil DuckDB) performans.
- Hatanın türü: "Emin değilim" diyerek %10 hata yapan bir model, uydurarak %5 hata yapan bir modelden çok daha güvenlidir.
- Maliyet dengesi: Pahalı modeller gerçekten aradaki fiyat farkına değer mi, yoksa onda bir fiyattaki model aynı işi çıkarabilir mi?
Kıyaslama Testinin Yapısı (InsightTrack Analyst Bench)
Benchmark, her biri 80 standart ve 40 zor vakadan (eşik değerdeki kritik değişimler gibi) oluşan 4 ana görev içerir:
- Araç seçimi (Tool choice): 23 araçlık katalogdan doğru aracı ve argümanları belirleme veya uygun araç yoksa "yok" diyebilme.
- Veri okuma (Data reading): InsightTrack'in gerçek çıktı biçimindeki sayıları doğru okuma ya da uydurmak yerine
not_availablesonucunu üretme. - Teşhis (Diagnosis): 8 haftalık trafik ve arama sonuçlarını inceleyerek değişimin gerçek olup olmadığını, yönünü ve kesin nedenlerini açıklama.
- SQL sorgulama: Yerleşik araçların yetmediği durumlarda DuckDB tabloları üzerinde doğru veriyi getiren sorgular üretme.
Yazılım geliştiriciler için temel çıkarım nettir: LLM tabanlı ajan geliştirirken genel sıralamalara güvenmek yerine, üretim ortamınızdaki ham veri ve araçları yansıtan özel değerlendirme (evaluation) setleri inşa etmelisiniz.
Orijinal kaynağa buradan ulaşabilirsiniz.
Bu konuyu derinlemesine öğrenmek isterseniz: AI Test Stratejileri modülüne göz atın.
Bu konuyu daha derinlemesine öğrenmek ister misin?
Edumints'teki ücretsiz kursları incele ve bugün başla.
Kurslara Göz At →