4 Modelde Akıl Yürütme Ayarını 'Yüksek'e Getirdim: Tek Bir Şeyi Düzeltti ama Her Şey İçin Fatura Kesti
Kaynak: dev.to
İçindekiler 3 başlık
Modern LLM API'leri ile uygulama geliştirirken karşılaştığımız en kritik Üretim Parametreleri kararlarından biri akıl yürütme çabasıdır (reasoning_effort). Kaggle Benchmarking Challenge kapsamında yapılan bu çalışma, bu parametreyi değiştirdiğimizde gerçekte ne olduğunu verilerle ortaya koyuyor.
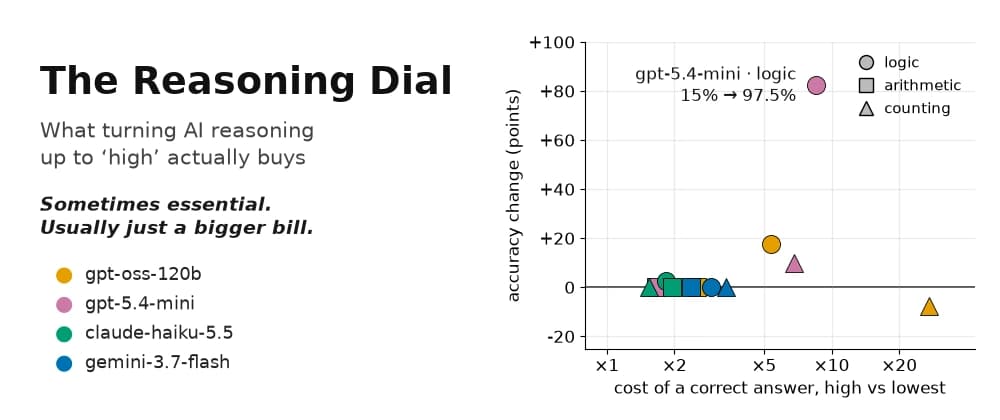
gpt-5.4-mini modeline yedi kişi, yedi gün ve on ipucundan oluşan bir mantık bulmacası ("Cuma günü konuşmayı kim yapıyor?") verildiğinde, reasoning_effort ayarı none iken model 18 çıktı token'ı ve $0.00024 maliyetle iki denemede de yanlış cevap olan Cleo yanıtını verdi (doğru cevap: Fay). Ayar high seviyesine getirildiğinde ise model 1,333 token harcadı, yaklaşık $0.006 maliyet çıkardı ve doğru cevap olan Fay yanıtını buldu.
Ancak aynı modele yine high ayarında "Bir keskiniz ve bir matkabınız var" cümlesindeki aletleri sayması istendiğinde model 10,016 yanıtını verdi. İki örnek tüm makaleyi özetliyor: Akıl yürütme ayarı bazen çok şey değiştirir, ancak çoğu zaman sadece faturayı büyütür.
Özet (TL;DR)#
Reasoning Dial, kodla üretilmiş aynı 60 soruyu, aynı istemi (prompt) ve aynı deterministik değerlendiriciyi sabit tutarak yalnızca reasoning_effort (none / low / medium / high) API parametresini değiştiren bir kıyaslama çalışmasıdır.
- Tek Gerçek Doğruluk Artışı: 4 model üzerinde yapılan 1,800 değerlendirilmiş çağrı sonucunda
highayarı istatistiksel olarak yalnızca tek bir gerçek doğruluk artışı sağladı: mantık bulmacalarındagpt-5.4-minibaşarısını %15'ten %97.5'e çıkardı. - Maliyet Artışı: 12 model × görev hücresinin 7'sinde doğruluk hiç değişmezken, doğru cevap başına maliyet 1.5 kat ile 3.4 kat arasında arttı.
- Tutarsız Parametre Davranışı: Bu ayar tüm sağlayıcılarda aynı şekilde çalışmıyor; bir model
highseviyesinde 14 kat daha fazla token harcarken, birinonedeğerini HTTP 400 hatasıyla reddediyor, bir diğeri isenoneayarında bile düşünmeye devam ediyor.
Benchmark Kaynakları ve Tasarım#
Çalışmanın hipotezleri ve analiz planı ana çalıştırmadan önce kayıt altına alınmış olup toplam çalıştırma maliyeti $4.20 tutmuştur:
- Kaggle Benchmark (Liderlik Tablosu):
kaggle.com/benchmarks/abeeralodhi/reasoning-dial - Dört Açık Görev:
dial-none·dial-low·dial-medium·dial-high - Kod, Ham Veriler ve Ön Kayıt:
github.com/Abeera81/reasoning-dial(docs/PREREGISTRATION.md)
Deney tasarımında her birinde 20 soru bulunan üç görev ailesi ve dört ayar seviyesi (none, low, medium, high) kullanılmıştır:
- Deduce (Çıkarım): Tek bir çözümü olan 7 kişilik, 7 günlük planlama bulmacaları.
- Arith (Aritmetik): Yüzde ve tam bölme içeren 6 adımlı sözel problemler (kontrol grubu).
- Distract (Dikkat Dağıtıcı): Çeldiricileri yok sayarak sahip olunan nesneleri sayma görevleri.
Neyi Kıyasladım ve Geliştiriciler İçin Pratik Çıkarımlar#
Hemen her modern model API'sinde reasoning_effort, thinking veya reasoning gibi bir parametre bulunur. Geliştiriciler bu ayarı genellikle sezgisel olarak belirler: "Zor bir soru, öyleyse high yapalım" veya "Üretim ortamındayız, low olsun." Oysa neredeyse hiç kimse bu kadranı çevirmenin gerçek etkisini ölçmez.
Yazılım geliştirme ve Ölçeklendirme ve Optimizasyon açısından çıkarımlarımız şunlardır:
- Varsayılan Olarak
highKullanmayın: Karmaşık çıkarım gerektirmeyen görevlerde yüksek akıl yürütme ayarı doğruluğu artırmadığı gibi aşırı düşünme (overthinking) nedeniyle basit sayma işlemlerinde bile halüsinasyonlara ve 3 kata varan maliyet artışına yol açabilir. - Göreve Göre Parametre Seçin: Yalnızca çok adımlı kısıt çözümü ve mantıksal çıkarım gerektiren darboğazlarda
highseviyesini tercih edin; standart iş akışlarında kendi verinizle test ederek en uygun seviyeyi belirleyin.
Kaynak ve atıf
Bu yazı, dev.to üzerinde yayımlanan içerikten yararlanılarak Edumints tarafından yapay zekâ desteğiyle Türkçe hazırlandı. Ayrıntılar ve yazarların kendi anlatımı için orijinaline bakabilirsin:
- dev.to/abeera_lodhi/i-turned-the-reasoning-dial-to-high-on-4-models-it-fixed-one-thing-and-billed-me-for-everything-41o5