16GB RAM ile Gemma 4: Yapılandırılmış Yapay Zeka İş Akışlarında Neler Mümkün?
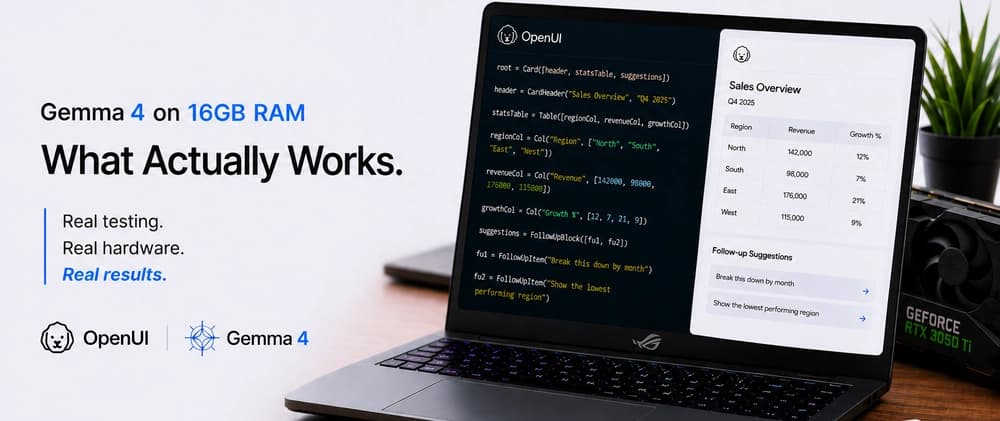
Yapay zeka modellerinin devasa sunuculardan çıkıp yerel makinelerimize inmesi, yazılım geliştirme süreçlerinde yeni bir dönemi başlattı. Google'ın Gemma 4 serisi, özellikle 16GB RAM gibi standart tüketici donanımlarında "yapılandırılmış çıktı" (structured output) üretme konusunda nelerin mümkün olduğunu yeniden tanımlıyor. Shogun444'ün OpenUI üzerindeki testleri, bu modellerin kod yazımı ve arayüz tasarımı gibi karmaşık iş akışlarındaki gerçek performansını gözler önüne seriyor.
İşte 16GB RAM üzerinde Gemma 4 deneyiminin detaylı dökümü:
-
E2B (2 Milyar Parametreli Model): Yerel Prototiplemenin Yeni Yıldızı Gemma 4'ün en küçük üyesi olan E2B, şaşırtıcı bir performans sergiliyor. Basit arayüz düzenleri ve tablo yapıları gibi istemlerde %70 gibi yüksek bir başarı oranına ulaşıyor. Bu model, özellikle tamamen çevrimdışı çalışması gereken prototipleme süreçleri için ideal. Ancak karmaşık gösterge panelleri (dashboard) veya derin iç içe geçmiş yapılarda başarı oranı %20-30 bandına çekiliyor. Bellek zinciri uzadıkça tutarlılık kaybolsa da, düşük donanımlı cihazlarda sunduğu hız ve temel işlevsellik takdire şayan.
-
E4B (4 Milyar Parametreli Model): Donanım Darboğazı 4 milyar parametreli model, çıktı kalitesi açısından E2B'nin bir adım önünde olsa da 16GB RAM üzerinde ciddi bir performans bariyerine takılıyor. Diğer geliştirici araçları ve IDE'lerle birlikte çalıştırıldığında bellek yetersizliği ana kısıtlayıcı faktör haline geliyor. Eğer sisteminizde başka ağır iş yükleri yoksa kullanılabilir, ancak çoklu görev performansı zayıf.
-
26B ve 31B Modelleri: Profesyonel Tutarlılığın Sınırı Gerçekten güvenilir ve üretim seviyesinde çıktılar 26B modeliyle başlıyor. 31B ise en tutarlı sonuçları veren, hiyerarşik yapıları en iyi anlayan model olarak öne çıkıyor. Ancak acı gerçek şu: 31B modeli 16GB RAM'de yerel olarak verimli çalışmıyor. Bu noktada OpenRouter veya Ollama Cloud gibi bulut tabanlı çözümler devreye giriyor.
Yazılım Geliştiriciler İçin Pratik Çıkarımlar: Bir yazılım öğrencisi veya geliştiricisi olarak bu verilerden şu dersleri çıkarabiliriz:
- Model Seçimi: Her iş için en büyük modeli kullanmak zorunda değilsiniz. Basit UI bileşenleri veya JSON şemaları oluşturmak için E2B gibi yerel modeller, gizlilik ve hız avantajıyla yeterlidir.
- Yapılandırılmış Çıktı Yetkinliği: Geleceğin yazılım dünyası, yapay zekanın ürettiği ham metinlerle değil, yapılandırılmış (structured) verilerle şekilleniyor. Modellerin syntax ve bileşen hiyerarşisi üzerindeki başarısını test etmek, onları doğru yönlendirmenizi sağlar.
- Hibrit Yaklaşım: Basit işler için yerel modelleri (Ollama üzerinden E2B), karmaşık mimari tasarımlar için bulut tabanlı büyük modelleri (31B) kullanmak en verimli yöntemdir.
Sonuç olarak Gemma 4, özellikle küçük modellerin yapılandırılmış veri üretme kapasitesini artırarak, düşük donanımlı makinelerde bile profesyonel seviyede yapay zeka destekli geliştirmeyi mümkün kılıyor.
Bu konuyu daha derinlemesine öğrenmek ister misin?
Edumints'teki ücretsiz kursları incele ve bugün başla.
Kurslara Göz At →