149 Bin Düzensiz Görselden Çevrim Dışı Tanıma Sistemine: Cihaz Üstü YOLO Eğitimi
Kaynak: dev.to
İçindekiler 3 başlık
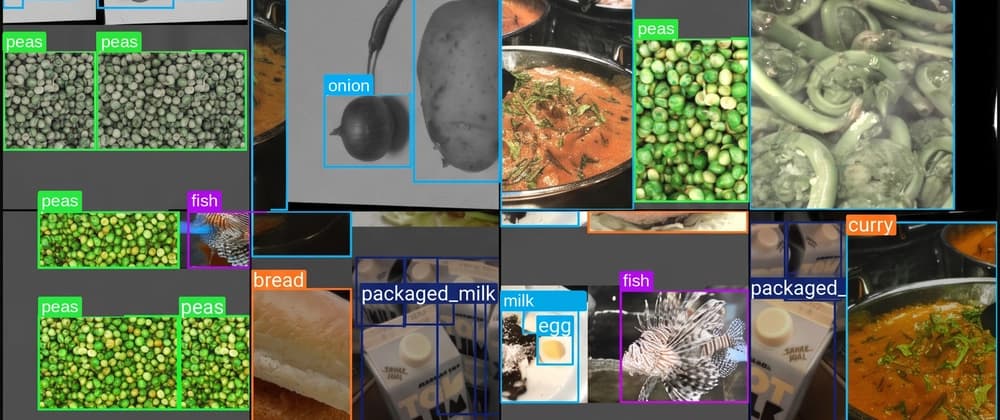
Mobil cihazlarda (iPhone veya iPad) internet bağlantısı olmadan tamamen çevrim dışı (offline) çalışan bir gıda tanıma sistemi geliştirmek, harici bir bulut veya API desteği bulunmadığı için doğrudan cihaz üstü optimizasyon gerektirir. Sistemin temel amacı; fotoğraftaki yiyecekleri tespit etmek, adetlerini saymak, bozulmuş veya çürümüş ürünleri işaretlemek ve gıda dışı nesneleri filtrelemektir. Bu tarz uç cihaz (on-device) projelerinde geliştiricilerin karşılaştığı asıl zorluk model mimarisinden ziyade, heterojen kaynaklardan gelen dağınık verinin yönetimidir.
Farklı kaynaklardan toplanan yaklaşık 149 bin görsel ile başlanan süreçte, sınırlayıcı kutu (bounding box) etiketleri içermeyen büyük bir veri kümesi elendiğinde geriye 11 farklı kaynaktan 49.158 görsel kalmıştır. Farklı veri setlerinin tutarsız etiketleme standartları, değişken görüntü kaliteleri ve yinelenen kopyaları nedeniyle eğitime başlamadan önceki en kritik mühendislik adımı, nelerin eleneceğini belirlemek olmuştur. Google Colab üzerinde uçtan uca yürütülen boru hattında karşılaşılan hatalardan çıkarılan dersler, çok kaynaklı veri projelerindeki veri hijyeninin önemini ortaya koymaktadır.
Veri Ne Kadar Hızlı Küçüldü?#
Veri temizleme hattında (pipeline) her aşamada verinin nasıl elendiğini adım adım takip etmek, gürültülü veriyi ayıklama stratejisinin temelidir:
- Orijinal Koleksiyon: Yaklaşık 149.000 görsel
- Etiketsiz Veri Kümesi Elendikten Sonra: 49.158 görsel
- Bulanıklık, Parlaklık ve Kopya Temizliği Sonrası: 31.589 görsel
- Kullanılabilir Etikete Sahip Temiz Görseller: 24.306 görsel
- Nihai Bölüm (Final Split): 20.660 eğitim (train) ve 3.646 doğrulama (validation)
Başlangıçtaki 49 bin görsel yerine yaklaşık 20 bin kaliteli veriyle eğitim yapılması; makine öğreniminde başarıyı getiren ana faktörün ham veri boyutu değil, veri kalitesi ve etiket doğruluğu olduğunu göstermektedir.
İlk Olarak GPU Kontrolü Yapmak#
Görsel işleme modellerinin eğitimi yoğun hesaplama gücü gerektirir. CPU üzerinde günler sürebilecek döngüler, Colab T4 GPU ile saatler içinde tamamlanabilir. Çalışma ortamının hazır olup olmadığını doğrulamak için ilk adım GPU denetimidir:
import torch
print('GPU available:', torch.cuda.is_available())
if torch.cuda.is_available():
    print('GPU name:', torch.cuda.get_device_name(0))
    print('VRAM:', round(torch.cuda.get_device_properties(0).total_memory / 1e9, 1), 'GB')
15.6 GB VRAM'e sahip Tesla T4 donanımı doğrulanarak çalışma zamanındaki bellek yetersizliği (OOM) risklerinin önüne geçilir.
Çalıştırma Yapılandırması (Run Configuration)#
Boru hattının kontrolünü merkezileştirmek amacıyla kritik parametreler kodun en başında tanımlanır:
RUN_MODE = 'train'('baseline_only' veya 'train')SAMPLE_SIZE = None(Hızlı test için 5000, tam eğitim için None)BLUR_THRESHOLD = 50HASH_DISTANCE = 5
Bu yapılandırma üç aşamalı bir test ve dağıtım metodolojisini destekler:
- Hazır modelin mevcut bilgisini ölçmek için bir temel seviye (baseline) denemesi,
- Tüm hattın hatasız çalıştığını doğrulamak için 5.000 görsellik pilot eğitim,
- Pilot aşaması başarılı olduğunda başlatılan tam ölçekli eğitim.
Kaynak ve atıf
Bu yazı, dev.to üzerinde yayımlanan içerikten yararlanılarak Edumints tarafından yapay zekâ desteğiyle Türkçe hazırlandı. Ayrıntılar ve yazarların kendi anlatımı için orijinaline bakabilirsin:
- dev.to/michellebuchiokonicha/i-turned-149k-messy-images-into-an-offline-recognition-system-3cp3