100 Metni SynthID ile Filigranladım ve Yerel LLM'lerden Temizlemesini İstedim: Dedektör Hâlâ İzleri Yakaladı
Kaynak: dev.to
İçindekiler 5 başlık
Yerel Modeller AI Filigranını Silebilir mi?#
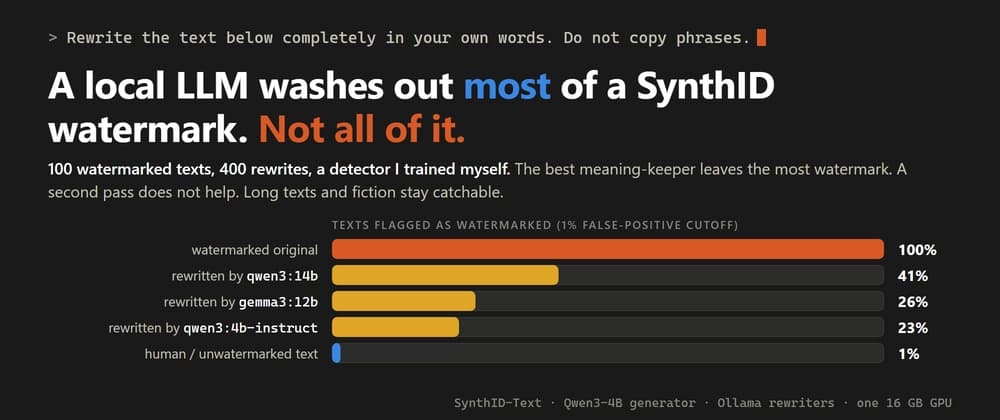
Bir yapay zeka metnini yerel bir açık kaynak modelden geçirip "bunu kendi kelimelerinle yeniden yaz" dediğimizde Google'ın SynthID-Text filigranı tamamen kaybolur mu? Önceki testlerde iyi bir 12–14B modelin anlamı koruyarak kelime dizilimlerini bozabileceği görülmüştü; ancak bu deneyde hem gerçek bir filigran hem de gerçek bir dedektör kullanıldı.
Kısa yanıt: Çoğunlukla evet, ancak tamamen değil. Standart dedektör, kullanılan modele bağlı olarak yeniden yazımların %3 ila %15'ini tespit etti. Daha basit ve hassas bir testte ise bu oran %23 ila %41 aralığına yükseldi. Anlamı en sadık şekilde koruyan modelin yeniden yazdığı uzun metinlerde tespit oranı %89'a ulaştı. Anlamı en iyi koruyan model aynı zamanda filigranı da en çok muhafaza etti; üstelik metni ikinci kez yeniden yazdırmak hiçbir katkı sağlamadı.
SynthID-Text Nasıl Çalışır?#
Google DeepMind tarafından geliştirilen ve Hugging Face transformers kütüphanesine eklenen SynthID-Text, model ağırlıklarını değiştirmez. Üretim anında bir logits işlemcisi son 4 tokene bakar; gizli bir anahtar kullanarak kelime dağarcığını "tercih edilen" ve "edilmeyen" olarak ikiye böler ve örneklemeyi tercih edilenlere yönlendirir. Metin doğal akışında okunur. Dedektör modelin kendisine ihtiyaç duymaz; yalnızca anahtar ve tokenizer yeterlidir. İnsan metinlerinde ortalama 0,500 olan bu tercih skoru (g-değeri), filigranlı metinlerde daha yüksek çıkar.
g-Değerlerini Karara Dönüştürmenin İki Yolu#
- Bayesyen Dedektör: Hugging Face örneğinde yer alan ~900 parametreli mini modeldir. Filigranlı ve temiz metinlerle eğitilerek metnin filigran taşıma olasılığını üretir.
- Ortalama Testi (Mean Test): Ortalama g-değerinin şans faktörünün üzerinde olup olmadığını z-skoru ile inceler. Filigransız metinlerde z yaklaşık 0 iken, 2.3 veya üzeri bir z-skoru temiz metinlerde yalnızca %1 oranında ortaya çıkar.
Deney Kurulumu#
Tüm süreç 16 GB VRAM'e sahip tek bir dizüstü bilgisayar GPU'sunda çalıştırıldı:
- Filigranlı Yazar:
Qwen/Qwen3-4B-Instruct-2507modeli bf16 formatında ve Hugging Face örneğindeki konfigürasyonla (30 anahtar, n-gram: 5, temperature: 1.0, top-k: 40)SynthIDTextWatermarkingConfigüzerinden çalıştırıldı. - Dedektör: ELI5 veri kümesinden 1.200 filigranlı cevap, 3.000 Wikipedia makalesi ve 480 temiz ELI5 cevabı ile TensorFlow kullanılmadan 6 dakikada (100 epoch, %70/%30 bölme) eğitildi. %1 yanlış pozitiflikte %99,7, %0,1'de ise %98,1 başarı gösterdi.
- Test Metinleri: 10 farklı türde (haber, teknik anlatım, bilim, kurgu vb.) 190-900 kelimelik 100 konu belirlendi; model bunların hem filigranlı hem temiz versiyonlarını üretti.
Geliştiriciler İçin Pratik Çıkarımlar#
Yazılım geliştiriciler ve yapay zeka mühendisleri için bu bulgular kritik bir ilkeyi ortaya koyuyor: Semantik sadakat ile filigran kalıcılığı doğrudan bağlantılıdır. Prompt tabanlı basit yeniden yazma işlemleri, anlamı korumaya çalışan güçlü modellerde n-gram istatistiksel izlerini tamamen yok edemez. Üretim ortamlarında içerik doğrulama ve filigran denetimi kurgularken tekil yeniden yazımlara aldanılmamalı, hassasiyeti ayarlanabilir çoklu dedektör katmanları kullanılmalıdır.
Kaynak ve atıf
Bu yazı, dev.to üzerinde yayımlanan içerikten yararlanılarak Edumints tarafından yapay zekâ desteğiyle Türkçe hazırlandı. Ayrıntılar ve yazarların kendi anlatımı için orijinaline bakabilirsin:
- dev.to/vadim_albarov/i-watermarked-100-texts-with-synthid-and-asked-local-llms-to-wash-it-out-the-detector-still-saw-500i